Microsoftが提供する「Azure AI Speech」は、音声認識(Speech to Text)や音声合成(Text to Speech)の機能をAPIやSDK経由でシステムに組み込めるクラウドサービスです(現在のMicrosoft Learnでの表記は「Azure Speech in Foundry Tools」)。
この記事で分かること
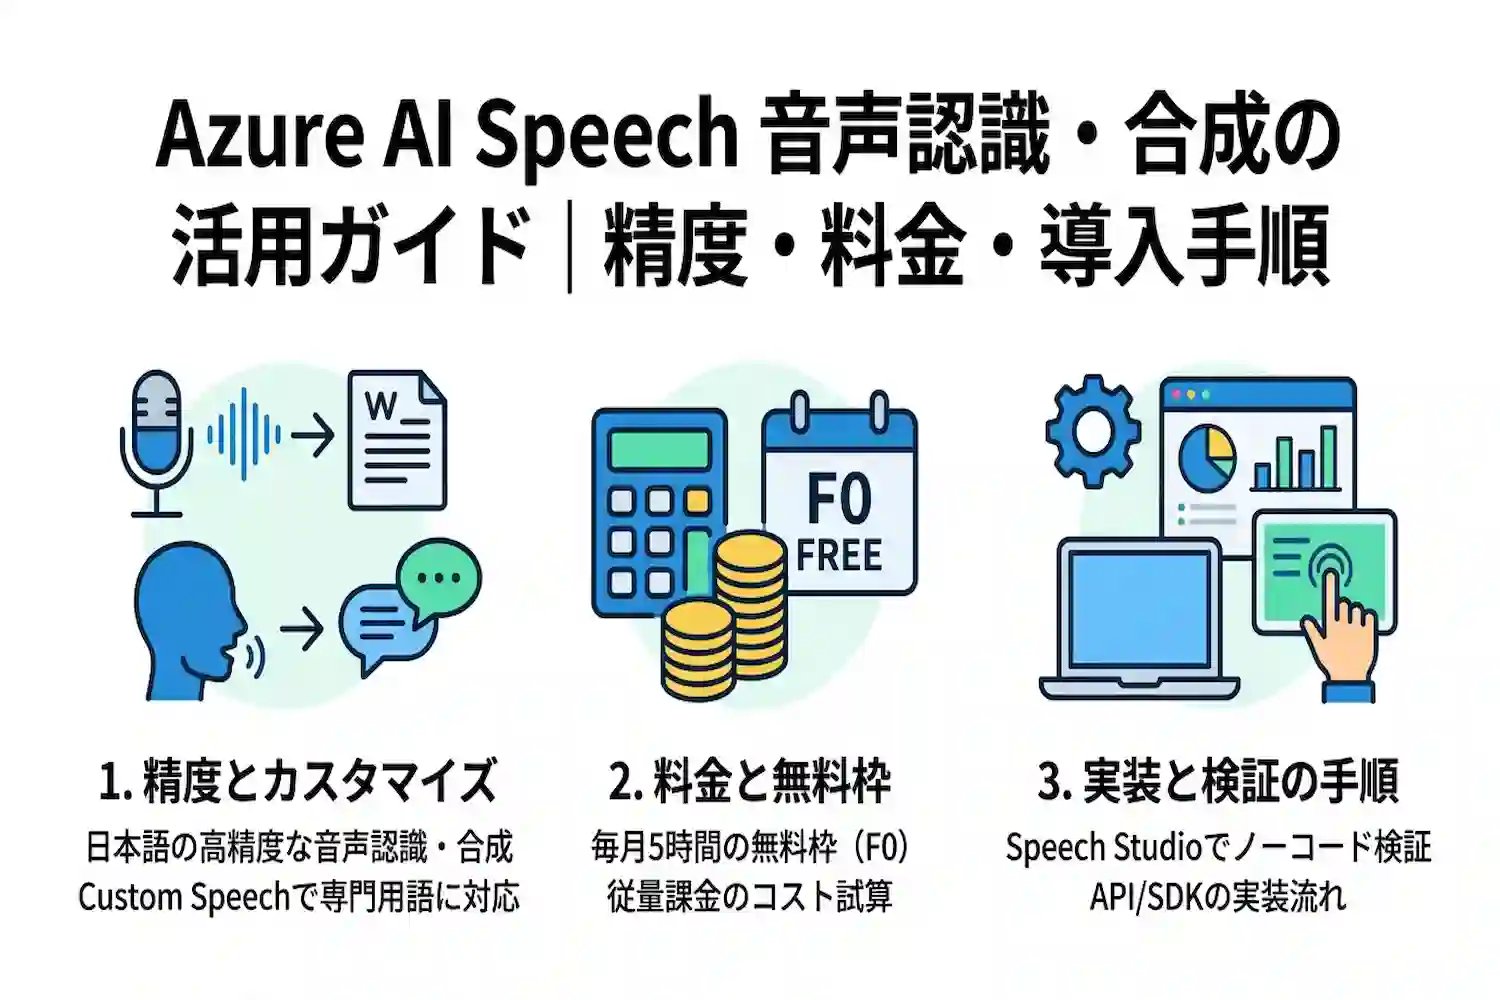
- 日本語の音声認識・ニューラル音声合成の精度とCustom Speechによる専門用語への対応方法
- 毎月5時間の音声認識などが使える無料枠(F0)の範囲と従量課金の考え方
- Speech Studioを用いたノーコードでの検証手順と実装の流れ
精度を左右する機能と検証の進め方、コスト試算の考え方、初期設定の手順を確認できます。
Azure AI Speechとは?主要な音声機能の概要
Azure AI Speech(旧称:Azure Cognitive Services Speech。現在のMicrosoft Learnでの表記は「Azure Speech in Foundry Tools」)は、Microsoftがクラウドプラットフォーム「Microsoft Azure」上で提供するAI音声処理サービスです。音声データのテキスト化や、テキストからの自然な音声の生成、リアルタイムでの多言語音声翻訳など、音声に関わる主要なAI機能が単一のサービスとして統合されています。
開発者はゼロから複雑な音響モデルや言語モデルを構築することなく、提供されているAPIやSDK(ソフトウェア開発キット)を呼び出すだけで、自社開発のアプリケーションや業務システムに音声機能を組み込むことが可能です。コールセンターの通話記録システム、Web会議の自動議事録作成ツール、動画コンテンツのナレーション生成など、などの用途が想定されます。
Microsoft公式のAzure AI Speechドキュメントで公開されている仕様に基づき、まずは本サービスが提供する主要な機能の役割と対象データを整理します。
| 主要機能 | 入力データと出力データ | 主な機能概要 | 代表的な活用シーン |
|---|---|---|---|
| 音声認識(Speech to Text) | 入力:音声 出力:テキスト |
マイク入力や音声ファイルから人間の発話を検知し、文字データへ変換する機能 | 会議の議事録作成、コールセンターの通話ログテキスト化、音声コマンド入力 |
| 音声合成(Text to Speech) | 入力:テキスト 出力:音声 |
文字データを解析し、人間のような抑揚やリズムを持つ音声データを生成する機能 | 自動音声応答(IVR)、館内アナウンス、デジタルコンテンツの音声読み上げ |
| 音声翻訳(Speech Translation) | 入力:音声 出力:多言語のテキスト・音声 |
発話された音声を認識し、指定した別の言語のテキストや音声へリアルタイムに変換する機能 | 多言語Web会議の同時通訳、訪日外国人向けの窓口案内システム |
なお、Azure AI Speaker Recognition(話者認識)は、Microsoftのリタイア告知(Message Centerのアーカイブ)で2025年9月30日以降の提供終了が案内されており、現行のSpeech概要の機能一覧にも記載がないため、本記事では扱いません。複数話者の発話を区別する「話者分離(ダイアライゼーション)」は、音声認識側の機能として提供されています。また、現行の機能一覧には、LLM Speech、言語識別、発音評価、テキスト読み上げアバターなども含まれています。
音声認識(Speech to Text)の仕組み
音声認識(Speech to Text)は、人間の話し言葉をコンピュータが解析し、テキストデータへと変換する機能です。入力された音声の周波数や波形から音素を捉える「音響モデル」と、文脈から最も適切な単語の並びや漢字変換を推測する「言語モデル」を組み合わせた仕組みで、発話内容を文字として出力します。
システムへ組み込む際は、用途や処理すべき音声データの性質に応じて、主に3つの処理方式から選択します。
- リアルタイム音声認識:マイクや電話回線から入力される音声ストリームを逐次処理し、発話と同時にテキストを出力する方式です。オンライン会議のリアルタイム字幕表示や、スマートスピーカーの音声操作などに適しています。
- バッチ文字起こし(Batch Transcription):ストレージ上に保存された大量の音声ファイルや長時間の録音データを、バックグラウンドで一括してテキスト化する方式です。コールセンターに蓄積された数千件の通話録音データの分析などに用いられます。
- 高速文字起こし(Fast Transcription):録音済みの音声ファイルに対し、同期的に、リアルタイムより高速に文字起こし結果を返す方式です。1ファイルあたり5時間未満・500MB未満といった上限があります。録音直後の会議データを素早くテキスト化して共有したい場面に向いています。
このように、リアルタイムのストリーミング処理から保存済み音声ファイルの一括バッチ処理まで、業務要件に応じた文字起こし方式を選択できる点がシステム設計上の強みです。また、数字表記への変換(ITN)や不適切な表現のマスクといった表示用テキストの整形は、公式ドキュメントでは表示テキスト形式(Display text format)として説明されています。既定の動作はリクエストの設定に左右されるため、公式ドキュメントで確認してください。
音声合成(Text to Speech)の特徴
音声合成(Text to Speech)は、入力されたテキストデータを解析し、デジタル音声へと変換して出力する機能です。従来の機械的な合成音声とは異なり、「ニューラル音声(Neural TTS)」が提供されており、自然な抑揚の音声を生成できます。
多様な言語や地域のアクセントに対応した標準音声(プリビルドニューラル音声)があらかじめ用意されているため、利用者はテキストと希望する話者のモデルを指定するだけで、即座に音声ファイルや音声ストリームを取得できます。さらに、単にテキストを棒読みさせるだけでなく、SSML(音声合成マークアップ言語)と呼ばれるXMLベースの記述を用いることで、音声の出力表現を細かく制御することが可能です。
- 読み上げ速度(話速)や声の高さ(ピッチ)、音量の部分的な変更
- 特定の単語やフレーズに対する強調表現の付与
- 文と文の間や、特定の箇所への自然な無音時間(ポーズ)の挿入
- 漢字の読み間違いを防ぐための、ふりがな(音素)の直接指定
- ニュースキャスター風、カスタマーサポート風、喜びや悲しみといった感情表現(発話スタイル)の切り替え(対応モデルのみ)
また、企業のブランドイメージに合わせた独自の声を生成したい場合には、特定の声優やナレーターの録音データを学習させて専用モデルを作る「カスタムニューラル音声(Custom Neural Voice)。Limited Accessの対象で、利用には登録が必要」や、音声に合わせて唇の動きを同期させた人物映像を生成する「テキスト読み上げアバター」といった拡張機能も提供されています。
音声翻訳と話者分離の活用法
Azure AI Speechには、単一言語での音声認識・音声合成だけでなく、複数言語間のコミュニケーションを支援する「音声翻訳(Speech Translation)」機能があります。
従来、音声を別言語へ翻訳するシステムを構築する場合、「音声認識でテキスト化」「機械翻訳APIで他言語へ変換」「音声合成で発話」という複数のシステムを連携させる必要がありました。Azure AI Speechの音声翻訳機能は、音声認識と翻訳を1つのサービスで扱えます。対応言語や翻訳音声の出力方法は公式ドキュメントで確認してください。用途としては、多言語Web会議や観光案内端末などが想定されます。
複数人が参加する会議や通話では、「誰がいつ話したか」を区別する話者分離(ダイアライゼーション)が役立ちます。公式ドキュメントで確認できた内容は以下の通りです。
- 高速文字起こしでは、想定する最大話者数(2〜35)を指定して話者分離を行えます。ただし、対象はモノラル(単一チャンネル)の音声のみです。
- リアルタイムの文字起こしでは、Speech SDKの会話文字起こし(ConversationTranscriber)で話者分離を扱えます。公式の制限表では、リアルタイム・バッチの最大話者数の記載は確認できませんでした。
なお、カスタムニューラル音声(およびカスタムのテキスト読み上げアバター)はLimited Accessのサービスで、利用には登録が必要です。承認を受けたユースケース以外では使用できません(Microsoftの透明性ノート)。
Azure AI Speechの音声認識と音声合成の精度を左右する機能と検証の進め方
システム開発や業務効率化において音声AIを導入する際、最も重視される指標が認識および生成の精度です。精度は音声の品質、話し方、専門用語の有無によって大きく変わります。本記事では、公式ドキュメントで確認できる機能と、自社の音声で精度を測る進め方を整理します。
日本語における音声認識の精度と文字起こし性能
日本語の音声認識(Speech to Text)では、同音異義語の判別や文脈に応じた漢字変換、適切な句読点の挿入が求められます。日本語(ja-JP)は、公式の言語サポート表で高速文字起こしなどに対応していますが、これらの精度は音声の条件によって変わります。
日本語の文字起こしの表示整形には、次のような処理が関係します(有無や設定は機能・リクエスト設定により異なります)。
- 句読点や疑問符などの表示整形(対応状況は要確認)
- 「えー」「あのー」といったフィラー(言い淀み)の扱い(除去できるかは、確認できた公式ドキュメントに記載がなく要確認)
- 話し言葉の数字を表示形式へ変換する逆テキスト正規化(ITN)。公式の例は英語(「twenty dollars」→「$20」)のため、日本語での変換結果は実際に検証してください
- 話者分離(ダイアライゼーション):高速文字起こしでは最大話者数の指定範囲が2〜35、モノラル音声のみ対応
同音異義語(「機会と機械」「決済と決裁」など)の判別は、前後の文脈によって結果が変わります。単語誤り率(WER)や文字誤り率(CER)は、録音環境や話者によって大きく変わり、公式に日本語の標準的な値は示されていないため、自社の実際の音声サンプルで測定して判断してください。
ニューラル音声による自然で人間らしい音声合成の精度
音声合成(Text to Speech)では、「ニューラル音声(Neural TTS)」が提供されています。日本語のイントネーションやアクセントの自然さは、音声や文章によって感じ方が異なるため、実際に試聴して選びます。
日本語のニューラル音声は複数用意されています(例:Nanami。最新の一覧は公式の言語・音声サポートで確認してください)。音声ごとに声質や向いている用途が異なるため、Speech StudioのVoice Galleryで試聴して選びます。また、音声合成マークアップ言語(SSML)を使用することで、出力される音声の表現を細かく制御できます。
| SSMLで調整可能な項目 | 具体的な制御内容と精度への影響 |
|---|---|
| 発話スタイルと感情表現 | 喜び、悲しみ、カスタマーサービス向け、ニュースキャスター風など、場面に応じた感情やトーンを付与する |
| ピッチと読み上げ速度 | 声の高さ(周波数)や話すスピードをパーセンテージや段階指定で微調整し、聞き取りやすさを最適化する |
| ポーズ(無音区間)の挿入 | 文節の区切りや段落の間にミリ秒単位で任意の間合いを設定し、自然な呼吸感を再現する |
| 読み仮名(Phoneme)の指定 | 人名や社名など、AIが誤読しやすい固有名詞に対して、発音記号やカナ表記で正確な読み方を強制する |
さらに、多言語音声(Multilingual Voices)に対応した音声では、日本語の文章中の英語フレーズも同じ声で読み上げられます(対応音声と発音品質は、実際に試聴して確認してください)。
カスタム音声(Custom Speech)による専門用語の精度向上
汎用的なベースモデルだけでは、医療・法律・製造業などの専門用語、あるいは自社の製品名や業界特有の略語を正しく認識できないケースがあります。このような課題を解決し、特定の業務領域に特化して認識精度を引き上げる機能がカスタム音声(Custom Speech)です。
カスタム音声では、利用者の用途に合わせて以下の学習データを追加し、ベースモデルをカスタマイズします。
| 学習データの種類 | 準備するデータの内容 | 精度が向上する対象 |
|---|---|---|
| プレーンテキスト | 専門用語や社内用語を含む文章のリスト | 特定ドメインの語彙や言い回しの文脈理解 |
| 発音データ | 単語の表記と発音(読み)を定義したデータ(形式は公式で確認) | 特殊な読み方をする固有名詞、アルファベット略語(全体の精度向上ではなく、特定キーワードの認識改善が目的) |
| 音声+人間が書き起こしたテキスト | 実際の利用環境で録音した音声ファイルと正解テキストのペア | 訛りや話し方、背景ノイズなどの音響面(日本語では音声と書き起こしのペアが必要) |
実務では、大掛かりな録音データを用意しなくても、固有名詞や専門用語のテキストリストと読み方を登録するだけで改善が期待できます(効果は音声と用語によって異なるため検証が必要です)。また、モデル全体を再学習させずに、特定の単語リストで認識を補助する「フレーズリスト(Phrase List)」機能(日本語ja-JPは公式の対応表に記載あり)もあり、手軽に専門用語の誤変換の軽減を試せます。
雑音環境や方言に対する認識精度の実力
実際のビジネス現場では、常に静かな環境で標準語だけが話されるとは限りません。工場内の稼働音、屋外の風切り音や交通騒音、コールセンターにおける周囲のオペレーターの声など、背景雑音(ノイズ)が混入する環境では認識精度が低下しやすくなります。
ノイズの影響は環境によって大きく異なるため、実際の録音環境で検証してください。工場の機械音や車内の走行音など、定常的に強い雑音が入る環境では、その環境で録音した音声と人間が書き起こした正解テキストのペアでカスタム音声を学習させる方法があります(公式ドキュメントでは、背景ノイズなどの音響面の改善にこのデータを使うとされています)。
関西弁や東北弁といった地域方言、強いなまりや不明瞭な発音では、認識精度が下がる可能性があります。方言特有の語彙などは、実際の発話音声と書き起こしテキストのペアによるカスタムモデルで改善を試せますが、効果は検証が必要です。
また、ソフトウェア側の調整だけでなく、音声入力時の物理的な条件を整えることでも認識精度は向上します。導入時に以下の環境整備を併用することで、雑音環境下での誤認識を最小限に抑えられます。
- 単一指向性マイクやノイズキャンセリング機能付きヘッドセットを使用し、周囲の環境音の集音を防ぐ
- 音声は公式が示す入力形式で用意する(高速文字起こしの例:WAV、MP3、OPUS/OGG、FLAC、AAC、WebMなど)。サンプリングレートなどの録音品質は精度に影響するため、公式の推奨仕様を確認する
- 複数人が同時に発話する状況を避け、1人ずつ発話する運用ルールやマイクの個別割り当てを行う
Azure AI Speechの無料枠と料金体系を詳しく解説
Azure AI Speechの料金プランは、初期検証向けの「Free(F0)」と、本番運用向けの従量課金制「Standard(S0)」、さらに大量利用向けの「コミットメントティア」の3段階で設計されています。利用する機能(音声認識・音声合成・音声翻訳など)や処理方式によって課金単位が異なるため、システム要件に合わせたプラン選択が重要です。なお、本記事の金額は米国ドル表記の目安です。円換算やリージョン別の価格については、Microsoft Azure公式のAzure AI Speech料金ページで確認できます。
※本記事の金額は、2026年10月時点で確認できた第三者の集計情報に基づく目安です。確認できた時点のMicrosoft公式の価格ページは金額が表示されない状態だったため、公式との照合はできていません。契約や見積もりの前に、必ず公式の価格ページと料金計算ツールで確認してください。
無料で試せるFree(F0)プランの制限と使える範囲
Free(F0)プランは、Azureアカウントを作成すれば毎月一定の利用枠まで無料で使えるプランです。毎月リセットされる無料枠が提供されるため、PoC(概念実証)や個人開発のテスト環境としてコストをかけずに精度を検証できます。
F0プランで毎月無料になる主な機能ごとの上限は以下の通りです。
| 対象機能 | F0プランの月間無料枠 | 備考・制限事項 |
|---|---|---|
| 音声認識(Speech to Text) | 月間 5時間まで | 標準モデルのリアルタイム処理が対象(カスタムモデルと枠を共有)。バッチ文字起こしは利用不可。 |
| 音声合成(Text to Speech) | 月間 50万文字まで | 標準のニューラル音声が対象。漢字は1文字を2文字として換算(公式)。 |
| 音声翻訳(Speech Translation) | 月間 5時間まで | リアルタイムでの音声翻訳が対象。 |
F0プランを利用する際は、利用量の上限以外にも以下のシステム制限に注意が必要です。
- 1つのAzureサブスクリプションあたりに作成できるF0リソース数の上限は、確認できた公式ページに記載がなく要確認
- バッチ文字起こしと高速文字起こしはF0では利用できない。カスタム音声(Custom Speech)のエンドポイントホスティングは、F0でも1モデル分が無料枠にある(未使用のモデルは7日後に停止される)
- リアルタイム音声認識・音声翻訳の同時リクエスト数が1に制限されており(調整不可)、複数ユーザーの同時利用には対応できない
無料枠の上限に達した後の動作は、確認できた公式ページに記載がなく要確認です。本番環境への移行時や、バッチ処理・複数同時接続のテストを行う段階で、Standard(S0)プランへアップグレードする運用が一般的です。
従量課金制(Standard)の具体的な料金単価
Standard(S0)プランは、実際に処理した音声の時間やテキストの文字数に応じて課金される従量課金制です。同時リクエスト数の上限は、S0の既定が100で、申請により調整できます(公式の制限表)。
音声認識(Speech to Text)の時間あたりの料金
音声認識は処理した音声データの「時間」で課金されます。処理方式(リアルタイムまたはバッチ)と、ベースモデルかカスタムモデルかによって単価が異なります。
| 利用モデル・処理方式 | 料金単価(目安) | 主な用途・特徴 |
|---|---|---|
| 標準モデル(リアルタイム処理) | $1.00 / 1時間 | オンライン会議の字幕表示やボイスボットなど、遅延のない即時変換が必要な用途。 |
| 標準モデル(バッチ処理) | 要確認(リアルタイムより低い単価) | 録音済みの会議データやコールセンターの通話記録をまとめて非同期処理する用途。 |
| 標準モデル(高速文字起こし) | 要確認(価格ページに区分あり。リージョンにより表示されない場合あり) | 録音済みファイルを同期的に素早く文字起こしする用途。 |
| カスタムモデル(リアルタイム処理) | $1.20 / 1時間 | 専門用語や社内用語を学習させたCustom Speechモデルによるリアルタイム変換。 |
| カスタムモデル(バッチ処理) | 要確認 | Custom Speechモデルを用いた録音済み音声ファイルの一括変換。 |
録音済みファイルを文字起こしする場合、バッチ処理を選ぶと、リアルタイム処理より低い単価で処理できます(差額は公式の価格ページで確認してください)。ただし、バッチ処理は即時性が必要な用途には向きません。
なお、Custom Speechを利用する場合は、変換料金に加えてモデルのトレーニング費用(第三者情報では1コンピューティング時間あたり約$10)と、エンドポイントのホスティング費用(価格ページに「1モデル・1時間あたり」の区分あり)が別途発生します。F0には1モデル分の無料ホスティング枠があります。
音声合成(Text to Speech)の文字数あたりの料金
音声合成は、音声に変換するテキストの「文字数(100万文字単位の換算)」で課金されます。公式ドキュメントでは、文字、数字、空白、句読点に加え、SSMLのマークアップ(<speak>と<voice>タグを除く)も課金対象とされています。また、日本語の漢字は1文字を2文字として換算されます(公式に「日本語の漢字を含む」と明記)。ひらがな・カタカナの扱いは、確認できた公式ページに記載がなく要確認です。
| 音声タイプ | 料金単価(100万文字あたり・目安) | 特徴 |
|---|---|---|
| 標準ニューラル音声(Prebuilt Neural) | $16.00 | 標準で用意されている自然な音声モデル。一般的な読み上げや自動応答に最適。 |
| ニューラルHD音声(Neural HD) | $22.00 | 長文の文脈に応じた抑揚や感情表現を強化した高音質モデル。 |
| カスタムニューラル音声(Custom Neural) | $24.00(HDは$48.00) | 特定の声優やナレーターの声を学習させた独自音声モデルでの合成。 |
標準ニューラル音声の場合、1文字あたり約$0.000016です。ただし漢字は2文字換算のため、5,000文字の記事でも課金対象の文字数は5,000を超えます。たとえば漢字が全体の3割(1,500文字)と仮定すると、課金文字数は約6,500文字となり、約$0.10(1ドル150円換算で約16円)です。独自の声を作る「カスタムニューラル音声」を運用する場合は、文字単価に加えてモデルのトレーニング費用とエンドポイントのホスティング費用(価格ページに「1モデル・1時間あたり」の区分あり)が固定費としてかかります。第三者情報ではトレーニングが1コンピューティング時間あたり約$52(1回の上限$936)、ホスティングが1モデル・1時間あたり約$4.04とされており、大企業や商用プロダクト向けの選択肢となります。なおカスタムニューラル音声は、利用にLimited Accessの登録が必要です。
コミットメントティアによる大量利用時の割引料金
毎月の利用量が安定している場合、月単位で一定の利用枠を事前購入する「コミットメントティア(Commitment Tiers)」が用意されている場合があります。ただし、対象機能、月間の利用量区分、割引率は、確認できた公式ページでは取得できませんでした(第三者情報では、音声認識に月2,000時間・10,000時間・50,000時間の区分が挙げられていますが、割引率は公式の数値ではありません)。見積もりの際は、公式の価格ページや販売窓口で確認してください。
また、インターネット接続のない環境でSpeechコンテナを「切断されたコンテナ(Disconnected containers)」として運用する際には、申請とコミットメントプランの購入が必要です(公式のSpeechコンテナ文書)。
料金シミュレーションとコストを抑えるポイント
実際のビジネスシーンを想定し、リアルタイム処理(目安$1.00/時間)と標準ニューラル音声(目安$16/100万文字)の単価を使った概算の考え方を示します(為替や税は含みません)。
- 社内会議の議事録作成(1回1時間の会議×月40回=月間40時間)
リアルタイム文字起こしを利用した場合、40時間 × $1.00 = 月額$40.00です。F0の無料枠は月5時間までのため、超える分はS0が必要です。会議の録音データを終了後にバッチ処理する場合は、バッチの単価(公式の価格ページで確認)で同様に計算します。 - 動画コンテンツやeラーニング教材のナレーション生成(1本5,000文字×月100本=月間50万文字)
1本5,000文字×100本で月間50万文字ですが、漢字は2文字換算のため課金文字数はその分増えます。漢字が全体の3割と仮定すると、1本あたり約6,500文字、月間65万文字です。S0の目安単価では 65万文字 ×($16.00 ÷ 100万)= 約$10.40となり、F0の無料枠(月50万文字)には収まりません。 - コールセンターの通話録音解析(月間3,000時間の通話データ)
リアルタイム処理(目安$1.00/時間)では、3,000時間 × $1.00 = 月額$3,000です。バッチ処理を選べばリアルタイムより低い単価で計算できます(単価は公式で確認)。話者分離などの追加機能の料金は機能ごとに異なるため、見積もり時に確認してください。
運用コストを最小限に抑えるには、処理の性質を見極めて最適なAPI方式を選択し、不要なリソース稼働を防ぐ設計が不可欠です。具体的に実践すべきコスト削減のポイントは以下の4点です。
- 即時性が求められない音声認識は、単価が低く設定されている「バッチ文字起こし」または「高速文字起こし(Fast Transcription)」へ切り替える
- 音声認識の前に無音区間(サイレンス)をカットする前処理を入れるか、発話区間検出(VAD)を活用して、無音部分に対する課金対象の音声時間を減らす(課金方式は公式で確認)
- 音声合成で頻繁に読み上げる定型文(挨拶や共通ガイダンスなど)は、毎回APIを呼び出すのではなく生成済みの音声ファイルをキャッシュして再利用する
- Custom Speechで精度向上を図る際、常時稼働のホスティング費用がかかる音響モデルの学習を行う前に、ホスティング費用が不要な「フレーズリスト(Phrase List)」機能で専門用語の認識率が改善するか試す
自社のシステム構成における正確な月額コストを算出したい場合は、Azure料金計算ツール(Pricing Calculator)で「Azure AI Speech」を選択し、想定される時間数や文字数を入力して見積もりを作成してください。
Azure AI Speechを始めるための導入手順とSpeech Studioの使い方
Azure AI Speechを実際の業務やシステム開発で利用するには、Microsoft Azure上で専用のリソースを作成し、認証情報を取得するか、ブラウザベースの専用ツールに接続する必要があります。ここでは、初期環境の構築手順から、プログラミング不要で音声の生成や文字起こしを試せる「Speech Studio」の操作方法、そしてシステムへ組み込むための実装手順を解説します。
Azureアカウントの作成とリソースの構築
Azure AI Speechを利用する最初のステップは、Azureアカウントの用意と、管理画面であるAzureポータル上でのSpeechリソースの作成です。まだアカウントを持っていない場合は、Microsoftアカウントと本人確認用の電話番号、クレジットカード情報など、Azureアカウントの登録に必要な情報を準備して登録を完了させます。
アカウントの準備ができたら、以下の手順でSpeechリソースを作成します。
- Azureポータルにサインインし、検索バーから「Foundry」や「Speech」などで検索して、Speech用のリソースを作成します(現在の公式クイックスタートでは「Foundry resource for Speech」の作成が案内されています。画面の表記は変わる場合があるため、最新のクイックスタートに従ってください)。
- 「作成」ボタンをクリックし、リソースの設定画面を開きます。
- サブスクリプション、リソースグループ、リージョン、名前、価格レベルの各項目を入力または選択します。
- 「確認および作成」をクリックし、入力内容の検証が完了したら「作成」を押してデプロイを実行します。
作成時に設定する各パラメータは、システムの通信速度や利用できる機能に直結します。それぞれの項目で指定すべき内容は以下の通りです。
| 設定項目 | 設定内容と選択のポイント |
|---|---|
| サブスクリプション | 利用料金の請求単位となる契約を選択します。 |
| リソースグループ | 関連するAzureリソースをまとめて管理するための論理的なグループです。新規作成するか、既存のものを選択します。 |
| リージョン | サーバーの物理的な配置場所です。日本国内からのアクセスが中心であれば、通信遅延(レイテンシ)を最小限に抑えるため「東日本(Japan East)」または「西日本(Japan West)」を選択します。 |
| 名前 | リソースを識別するための任意の名前を半角英数字とハイフンで入力します。 |
| 価格レベル | 無料で試用する場合は「Free F0」、本番稼働や制限のない検証を行う場合は「Standard S0」を選択します。なお、F0の作成可能数の上限は要確認です。 |
デプロイが完了したら、作成したリソースの画面へ移動し、「Go to resource(リソースに移動)」から、キーとエンドポイント(またはリージョン)を確認できる画面を開きます(公式クイックスタートの案内)。ここに表示される「KEY 1(またはKEY 2)」と「場所/地域(リージョン名)」、および「エンドポイント」の値は、外部プログラムからAPIやSDK経由で機能を呼び出す際の認証情報として必須になるため、外部に漏洩しないよう厳重に管理してください。
ノーコードで試せるSpeech Studioの基本操作
リソースの作成後、コードを1行も書かずにブラウザ上で音声認識や音声合成の挙動を確認できるWebツールがSpeech Studioです。開発に着手する前の要件定義や、音声コンテンツの直接制作にそのまま活用できます。なお、公式ドキュメントには、Microsoft Foundryポータルでも、サインアップやコーディングなしで音声認識・音声合成を試せると案内されています。
Speech StudioへアクセスしてAzureアカウントでサインインすると、先ほど作成したSpeechリソースの選択を求められます。対象のサブスクリプションとリソースを紐付けることで、スタジオ内のすべての機能が開放されます。
画面上には目的別にタイル形式でメニューが並んでおり、主に以下の操作を画面上のクリック操作とファイルアップロードだけで実行できます。
- リアルタイムの音声テキスト変換:PCのマイクに向かって話した内容や、ドラッグ&ドロップした音声ファイル(WAVやMP3など)が即座にテキスト化される様子を確認できます。同時に、変換結果がJSON形式でどのように出力されるかも画面上で閲覧可能です。
- 音声ギャラリーとオーディオコンテンツの作成:日本語を含む各国のニューラル音声モデルを一覧から試聴できます。「オーディオコンテンツの作成」メニューでは、テキストを入力した後にGUI上で話者の変更、話す速度(ピッチやレート)の微調整、特定の単語の読み方やポーズ(間)の挿入を行い、完成した音声データをファイルとしてダウンロードできます。
- カスタムモデルのトレーニング管理:独自の学習データ(音声ファイルやテキストリスト)をアップロードし、自社の業務環境に特化した認識モデルや合成モデルを画面上の指示に従って構築・テストできます。
APIやSDKを使ったシステムへの実装フロー
業務アプリケーションやWebサービスへAzure AI Speechの機能を組み込む場合は、Microsoftが提供する「Speech SDK」または「REST API」を利用します。マイクからのリアルタイム入力や長時間のストリーミング処理、イベント駆動型のきめ細かい制御を行う場合は、Speech SDKの利用が基本となります。一方、録音済みファイルの高速文字起こしやバッチ文字起こし、カスタム音声の管理には、REST APIが使われます(公式ドキュメント)。
Speech SDKを用いてシステムへ実装する際の標準的な開発フローは以下の通りです。
- 開発環境へのSDKパッケージのインストール:使用するプログラミング言語のパッケージマネージャー(Pythonであればpip、C#/.NETであればNuGet、JavaScriptであればnpmなど)を使い、クライアントライブラリ(パッケージ名は言語ごとに異なります。例:JavaScriptは
microsoft-cognitiveservices-speech-sdk、Pythonはazure-cognitiveservices-speech)を導入します。 - 構成オブジェクト(SpeechConfig)の初期化:Azureポータルで取得した「キー」と「リージョン」を引数に渡し、接続設定を保持するインスタンスを生成します。この段階で、認識または合成に使用する言語(日本語なら
ja-JP)や、音声合成の具体的な話者名(例:ja-JP-NanamiNeural)を指定します。 - 入出力設定(AudioConfig)の定義:音声認識の場合は「デフォルトのマイク入力」または「指定パスの音声ファイル」、音声合成の場合は「デフォルトのスピーカー出力」または「保存先のファイルパス」を指定するオブジェクトを作成します。
- クライアントの生成と処理の実行:構成オブジェクトと入出力設定を組み合わせて、認識用の「SpeechRecognizer」または合成用の「SpeechSynthesizer」を生成します。その後、単発処理(
RecognizeOnceAsyncやSpeakTextAsync)や連続認識処理(StartContinuousRecognitionAsync)のメソッドを呼び出します。
実装時に最も注意すべき点は、ソースコード内にAPIキーを直接記述(ハードコーディング)しないことです。キーが流出すれば第三者に不正利用され、従量課金による高額な請求が発生する原因となります。本番環境への実装時は、OSの環境変数から読み込む仕組みにするか、「Azure Key Vault」などのシークレット管理サービス、あるいは「Microsoft Entra ID(旧Azure Active Directory)」を用いたトークンベースのロールベースアクセス制御(RBAC)によって認証を行う設計にしてください。また、ネットワークの一時的な切断や処理失敗に備え、SDKから返される結果オブジェクトのステータス(成功・キャンセル・エラー理由)を判定する例外処理を必ず組み込みます。
よくある質問(FAQ)
Azure AI Speechで生成した音声データは商用利用できますか?
生成した音声データの商用利用や権利の扱いは、契約しているMicrosoftの利用規約(製品条項など)に従います。本記事では条項の文言までは検証していないため、商用公開の前に最新の規約を確認してください。
ただし、特定の人物の声を再現する「カスタムニューラル音声(Custom Neural Voice)」はLimited Accessのサービスです。運用する際は、Microsoftの責任あるAIに関するガイドラインに基づき、以下の条件を満たす必要があります。
- Limited Accessの登録フォームで申請し、承認を受けたユースケースの範囲でのみ利用すること
- 音声を提供する声優やナレーター本人から、音声の作成と、利用期間・用途・内容上の制限を含む明示的な書面による許可を得ること
- 合成音声がAIによって生成されたものであることを、エンドユーザーに対して分かりやすく開示すること
標準で用意されているニューラル音声に事前審査が必要かどうかは、本記事では検証していません。誤解や重大な影響を招く恐れのある用途の制限も含め、公開前に利用規約と責任あるAIに関する文書を確認してください。
Azure AI Speechに入力した音声データはAIの学習に利用されますか?
確認できたMicrosoft Learnのデータ・プライバシー・セキュリティのページには、顧客データを基盤モデルの学習に使うかどうかの記述はありませんでした。そのため本記事では「学習に使われない」と断定しません。契約条件やMicrosoft Trust Centerで確認してください。
セキュリティとプライバシーの仕様については、Azure AI Speechのデータ、プライバシー、セキュリティに関する公式ドキュメントで確認できた仕様は以下の通りです(音声認識に関するページです)。
- リアルタイム音声認識の音声入力は、Azureサーバーのメモリ内でのみ処理され、保存データは残らない。リアルタイム音声認識、高速文字起こし、発音評価、音声翻訳では、Microsoftは顧客から提供されたデータを保持・保存しない
- バッチ文字起こしでは、生成された文字起こしの保存先を顧客が管理できる(自分のストレージ、または未指定ならMicrosoftのストレージ)。Microsoftのストレージに保存する場合は、timeToLiveパラメーターによる自動削除、または削除APIによる削除ができる
- カスタム音声の学習データの扱いや、人間によるデータレビューの有無は、確認できたページに記載がないため要確認
社内会議の録音データやコールセンターの通話記録など、機密性の高い音声を扱う場合は、上記の仕様に加えて、契約条件や社内のセキュリティ規程に照らして確認してください。
オフライン環境やオンプレミス環境でもAzure AI Speechは使えますか?
Dockerコンテナ技術を用いた「Speechコンテナ」を導入することで、オンプレミス環境などでも音声認識・音声合成を実行できます。医療施設の院内システムや工場の閉域網など、セキュリティポリシーによって音声データを外部のクラウドへ送信できない環境に有効です。
ただし、すべての処理が完全にオフラインで完結するわけではありません。公式ドキュメントでは、Speechコンテナは課金情報をAzureへ常に送信するよう構成する必要があり、Azureとの接続なしでは(通常の構成では)実行できないとされています。提供されているコンテナは、音声認識、カスタム音声認識、言語識別、ニューラル音声合成です。送信される情報の詳細は、公式のコンテナ文書で確認してください。
インターネットから切り離した環境(エアギャップ環境)で運用する場合は、申請フォームの提出と承認、およびコミットメントプランの購入が必要です(公式)。年間契約であることやアカウントマネージャー経由であることは、確認できた公式ページに記載がありません。
Azure OpenAI Serviceと連携して音声対話システムを作れますか?
Azure AI SpeechとAzure OpenAI Serviceを組み合わせることで、人間の発話を聞き取り、文脈を理解して自然な声で返答する高度なAI音声対話システムを構築できます。コールセンターの自動応答(ボイスボット)や、店舗・受付のAIアシスタントなどに考えられる構成です。音声対話向けには、Voice Liveという機能も公式のシナリオとして紹介されています。
システム連携の基本的な処理フローは以下の通りです。
- マイクから入力されたユーザーの話し言葉を、Azure AI Speechの音声認識(Speech to Text)でテキストデータに変換する
- 変換されたテキストをプロンプトとしてAzure OpenAI Service(GPT-4oなどの大規模言語モデル)へ送信し、回答テキストを生成する
- 生成された回答テキストをAzure AI Speechの音声合成(Text to Speech)へ渡し、音声データに変換してスピーカーから再生する
対話のレスポンス速度を高めるには、Azure OpenAI Serviceのストリーミング出力機能を活用し、回答の文章がすべて完成するのを待たずに、句読点や文節単位で順次音声合成へ渡す実装が効果的です。さらに、Azure AI Speechの「テキスト読み上げアバター」機能を追加すれば、音声に合わせてアバターを画面に表示し、視覚的な接客システムへ拡張する構成も考えられます。
サポートされているプログラミング言語には何がありますか?
システム開発を効率化する専用のクライアントライブラリ(Speech SDK)が複数のプログラミング言語向けに提供されており、OSやプラットフォームに合わせて選択できます。主要な対応言語とそれぞれの主な用途は以下の通りです。
| プログラミング言語 | 対応プラットフォーム・環境 | 主な開発用途 |
|---|---|---|
| C# (.NET) | Windows、Linux、macOS、Mono、UWP | Windowsデスクトップアプリ、業務システムなど |
| Python | Windows、Linux、macOS | AI・機械学習パイプラインへの組み込み、バッチ処理、データ分析スクリプト |
| JavaScript / TypeScript | Webブラウザ、Node.js | ブラウザ上でマイク入力や音声再生を行うWebアプリケーション、サーバーサイド開発 |
| Java | Windows、Linux、macOS、Android | 大規模なエンタープライズ向けバックエンドシステム、Androidネイティブアプリ |
| Swift / Objective-C | iOS、macOS | iPhone・iPad向けのモバイルアプリケーション、Mac向けネイティブアプリ |
| C++ | Windows、Linux、macOS | 低遅延が求められるリアルタイム処理など |
| Go | Linux | マイクロサービスアーキテクチャや高並行処理を行うバックエンドサーバー |
表に記載のないプログラミング言語(PHP、Ruby、Rustなど)を使用する場合でも、HTTPリクエストを送受信できる環境であれば、Azure AI SpeechのREST APIを直接呼び出して音声認識や音声合成の機能を実装できます。ただし、長時間のリアルタイム音声ストリーミングや細かなイベント制御を行う場合は、Speech SDK対応言語の利用が向いています。
まとめ
本記事では、Azure AI Speechの機能や精度、料金体系、導入手順を解説しました。
- 音声認識・合成・翻訳を備え、カスタム学習により専門用語の認識精度の向上を試せる
- 毎月更新される無料枠(F0)があり、有料の従量課金制も利用時間や文字数に応じて課金される(金額は公式で確認)
- Speech Studioを使えば、ブラウザ上でコーディング不要で精度を検証できる
まずはAzureの無料アカウントを作成し、Speech Studioで実際の音声認識や音声合成の精度を体験してみましょう。