この記事で分かること
- Gemini 1.5 FlashとProの処理速度・推論精度・API料金の具体的な差
- コンテキストウィンドウの最大トークン数など共通するマルチモーダル性能
- チャットボット構築やプログラミング生成など目的別のモデル選定基準
- Google AI StudioやVertex AIを用いた実際のモデル切り替え手順
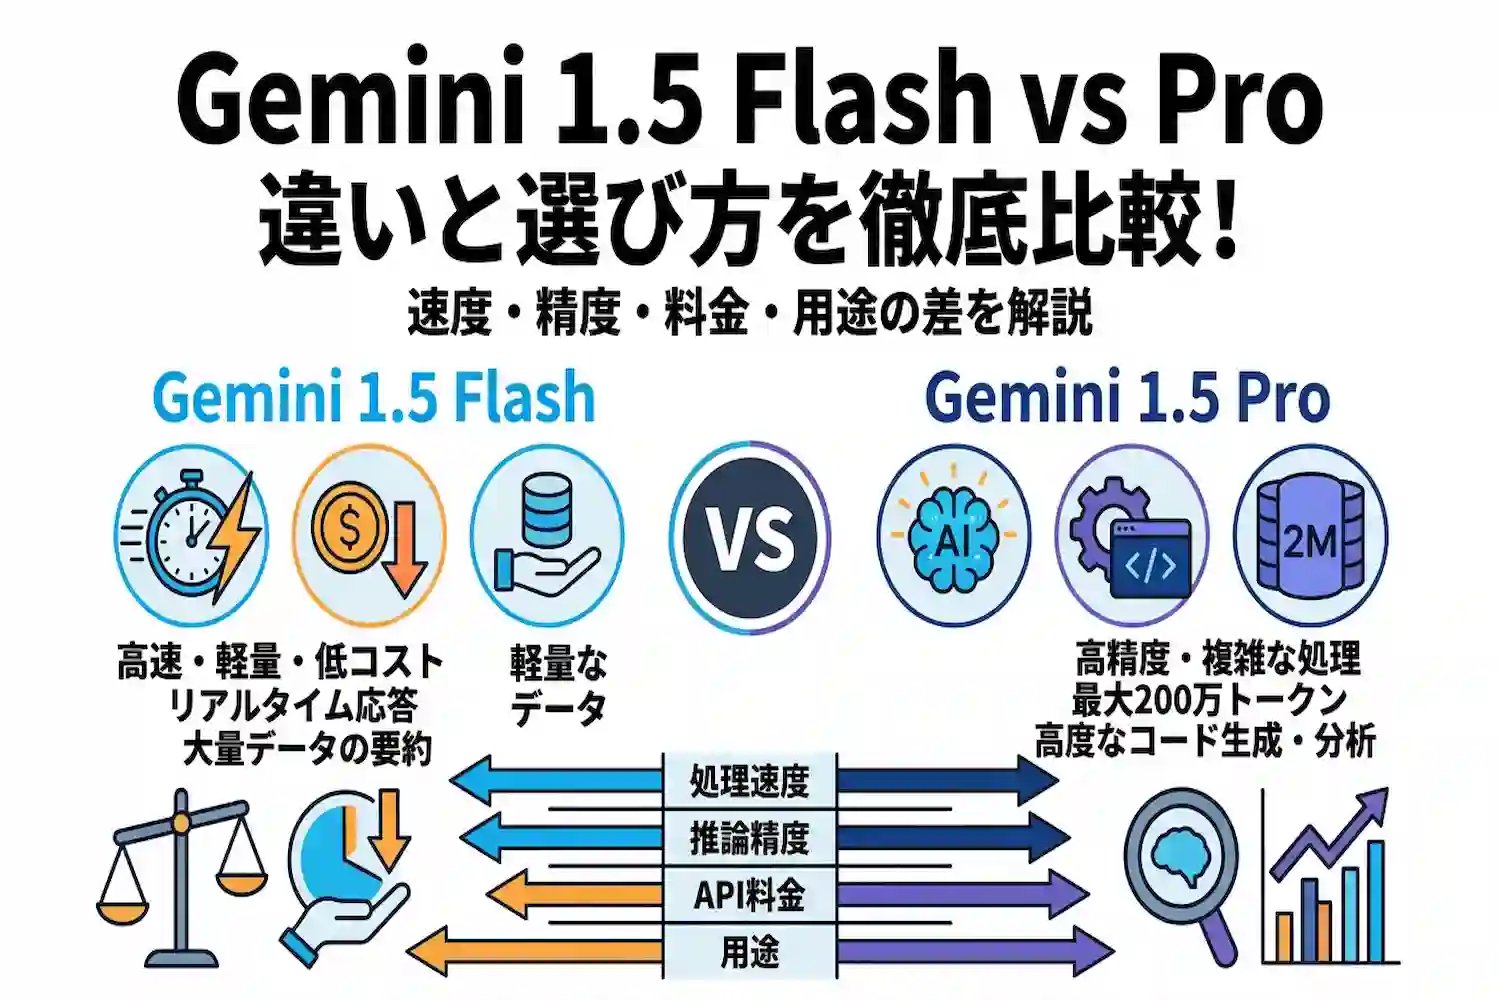
Googleの生成AIであるGemini 1.5 FlashとGemini 1.5 Proの決定的な違いは、処理速度と推論精度のバランス、およびAPI利用時のトークン単価にあります。Flashは軽量・高速かつ低コストで、リアルタイム応答や大量データの要約に最適です。一方、Proは高度な推論能力を持ち、最大200万トークンのコンテキストウィンドウを活かした複雑なコード生成や長尺動画の分析に適しています。本記事では両モデルのスペックや料金体系を比較し、開発するシステムの要件や予算に応じた使い分けの判断基準を提示します。
Gemini 1.5 FlashとProの基本的な違いと概要
Googleが提供する生成AI「Gemini 1.5」シリーズにおいて、Gemini 1.5 FlashとGemini 1.5 Proは処理速度とコストを重視するか、推論の深さと精度を重視するかという明確な役割の違いを持っています。開発者や企業がシステムにAIを組み込む際、それぞれの特性を把握することで、要件と予算に合致したモデル選定が可能になります。
Google AI for Developersの公式ドキュメントで公開されている仕様に基づき、両モデルの基本的な位置付けと全体像を比較します。
| 比較項目 | Gemini 1.5 Flash | Gemini 1.5 Pro |
|---|---|---|
| モデルの設計思想 | 軽量・高速処理・低コストに特化 | 高度な推論・複雑なタスク処理に特化 |
| 主な強み | 短い応答時間(低レイテンシ)と高いスループット | 文脈の深い理解と論理的思考力 |
| 対応モダリティ | テキスト、画像、音声、動画 | テキスト、画像、音声、動画 |
| コンテキストウィンドウ | 最大100万トークン | 最大200万トークン |
軽量で高速な処理に特化したGemini 1.5 Flashの特徴
Gemini 1.5 Flashは、応答までの待機時間を最小限に抑え、大量のリクエストを効率よく処理するために設計された軽量モデルです。上位モデルであるGemini 1.5 Proの知識や能力を、より小さなモデルへ引き継ぐ「蒸留(Distillation)」と呼ばれる技術を用いて開発されました。
この設計により、日常的なテキスト処理やデータ抽出に必要な実用的な精度を維持しつつ、リクエストから最初のトークンが出力されるまでの時間と全体の生成速度を大幅に短縮している点が最大の特徴です。APIの呼び出し頻度が高いサービスや、ユーザーを待たせたくないシステムへの導入に適しています。
高度な推論と複雑なタスクに向くGemini 1.5 Proの特徴
Gemini 1.5 Proは、複数のステップを要する論理的思考や、高度な専門知識が求められるタスクを正確にこなすための汎用・高性能モデルです。モデル内部で必要な計算領域のみを動かし処理を最適化する「MoE(Mixture-of-Experts)」アーキテクチャを採用しており、膨大な情報から微細な文脈や法則性を読み取る能力に優れています。
単純な情報検索や定型的な文章作成にとどまらず、複数の条件が絡み合う指示の遂行や、専門的なドキュメントの比較・分析など、出力の質が最優先される場面で真価を発揮します。
両モデルに共通するマルチモーダル性能とコンテキストウィンドウ
処理速度と推論能力に差がある一方で、両モデルにはGoogleのAI基盤ならではの強力な共通機能が備わっています。導入を検討する上で押さえておくべき主な共通点は以下の通りです。
- テキスト・画像・音声・動画を単一のモデルで直接処理できるネイティブマルチモーダル性能
- 外部データベースを検索する仕組み(RAG)を構築せずに長大なデータを一度に入力できるコンテキストウィンドウ
- JSON形式での出力指定や外部ツールと連携するFunction Callingなどの開発者向け機能
両モデルともに設計段階からマルチモーダルモデルとして訓練されているため、たとえば「音声データを文字起こししてからテキストAIに読ませる」といった複数モデルの組み合わせが不要です。動画の映像と音声、あるいはPDF内の図表とテキストをそのままプロンプトに入力し、横断的に理解させることができます。
また、一度に処理できる情報量を示すコンテキストウィンドウが極めて広い点も共通しています。最大トークン数の上限には差があるものの、Flashの100万トークンであっても、数万行のソースコードや数百ページの書籍データを丸ごとプロンプトに含めることが可能です。したがって、扱うデータの種類(モダリティ)ではなく、そのデータに対して「どれだけ複雑な処理を求めるか」がモデル選択の基本軸となります。
Gemini 1.5 FlashとProのスペックと性能の差を徹底比較
Gemini 1.5 FlashとGemini 1.5 Proは、基盤となるアーキテクチャを共有しながらも、処理速度、推論の深さ、そして運用コストにおいて明確な性能差が設けられています。まずは両モデルの主要スペックの全体像を以下の表で確認してください。
| 比較項目 | Gemini 1.5 Flash | Gemini 1.5 Pro |
|---|---|---|
| 最大コンテキストウィンドウ | 最大100万トークン | 最大200万トークン |
| 処理速度・レイテンシ | 非常に高速(低レイテンシ) | 標準的(深層推論のためFlashより時間を要する) |
| 推論能力・精度 | 定型処理や要約で高い実用性 | 複雑な論理思考・高度な専門タスクで最高水準 |
| API入力料金(12.8万トークン以下) | $0.075 / 100万トークン | $1.25 / 100万トークン |
| API出力料金(12.8万トークン以下) | $0.30 / 100万トークン | $5.00 / 100万トークン |
| 無料枠のレート制限(RPM) | 15 RPM(1分あたりのリクエスト数) | 2 RPM(1分あたりのリクエスト数) |
処理速度とレイテンシの違い
システム開発や業務効率化において体感しやすい違いが、プロンプトを入力してから最初の応答が始まるまでの時間(TTFT:Time to First Token)と、1秒あたりに生成されるトークン数(スループット)です。Gemini 1.5 Flashは、上位モデルであるProから知識を転移する「蒸留(Distillation)」と呼ばれる技術を用いて軽量化されており、計算リソースの消費を抑えることで圧倒的な低レイテンシを実現しています。
一方、Gemini 1.5 Proはパラメータ数が多く、入力された情報に対して多角的な文脈理解と深い推論プロセスを経るため、Flashと比較すると応答開始までに数秒のタイムラグが生じます。特に数十万トークンにおよぶ長大なドキュメントや動画データを読み込ませた場合、Flashは数秒で処理を終えるケースが多いのに対し、Proは全体の構造を精緻に解析するためにより多くの処理時間を必要とします。
回答の精度と推論能力の差
回答の正確性や論理的思考力を測る各種ベンチマークテストにおいては、Gemini 1.5 Proが明確な優位性を示しています。Google DeepMindの公開データによると、大学レベルの知識を問う「MMLU」や、高度な数学的推論を測定する「MATH」、プログラミング能力を測る「HumanEval」などの主要指標全般で、ProはFlashを上回るスコアを記録しています。
このスペック差は、複数の条件が絡み合うタスクで顕著に表れます。たとえば、単一ドキュメントからの情報抽出や定型フォーマットへの変換といった処理では、FlashでもProに近い精度を発揮します。しかし、複数の専門領域を横断する推論や曖昧な指示からの意図汲み取りにおいてはGemini 1.5 Proの独壇場となります。多段階のロジックを必要とする指示を与えた場合、Flashでは条件の一部を見落とすことがありますが、Proは前提条件を維持したまま論理の飛躍がない回答を生成します。
API利用時の料金体系とコストパフォーマンスの比較
システムへAPIを組み込む際、モデルの性能と並んで重要になるのがランニングコストです。両モデルの料金設定には十数倍の開きがあり、リクエストの規模が大きくなるほど運用費用に直結します。開発者はタスクの難易度と予算を照らし合わせ、最適なコストパフォーマンスを発揮するモデルを選択する必要があります。
入力トークンと出力トークンごとの価格差
Google AI for Developersの料金ページで公開されているPay-as-you-go(従量課金)プランでは、1回のプロンプトで扱うトークン数が12万8,000トークン以下か、それを超えるかによって単価が2段階に分かれています。それぞれの100万トークンあたりの具体的な価格は以下の通りです。
| 課金区分(100万トークンあたり) | Gemini 1.5 Flash | Gemini 1.5 Pro | 価格差(Pro / Flash) |
|---|---|---|---|
| 入力料金(12.8万トークン以下) | $0.075 | $1.25 | 約16.7倍 |
| 入力料金(12.8万トークン超) | $0.15 | $2.50 | 約16.7倍 |
| 出力料金(12.8万トークン以下) | $0.30 | $5.00 | 約16.7倍 |
| 出力料金(12.8万トークン超) | $0.60 | $10.00 | 約16.7倍 |
| コンテキストキャッシュ(12.8万トークン以下) | $0.01875 | $0.3125 | 約16.7倍 |
表の通り、Gemini 1.5 FlashのAPI利用料金はProの約16分の1以下という極めて安価な水準に設定されています。また、両モデルとも12万8,000トークンを超えると単価が2倍になる仕組みや、同一の大量データを繰り返し参照する際にコストを抑えられる「コンテキストキャッシュ」の割引率は共通しています。大量のデータを日常的に処理する環境では、Flashを選択することでAPIコストを90%以上削減できる計算になります。
無料枠の制限と有料プランへの切り替え基準
Google AI Studio経由でAPIを利用する場合、開発やテスト目的で使える無料枠(Free tier)が両モデルに用意されていますが、実運用に耐えうるかどうかはレート制限(利用上限)の違いによって分かれます。無料枠における制限の違いは以下の通りです。
| 無料枠の制限項目 | Gemini 1.5 Flash | Gemini 1.5 Pro |
|---|---|---|
| RPM(1分あたりのリクエスト数) | 15 RPM | 2 RPM |
| TPM(1分あたりのトークン数) | 100万 TPM | 32,000 TPM |
| RPD(1日あたりのリクエスト数) | 1,500 RPD | 50 RPD |
| モデルの学習へのデータ利用 | 利用される(オプトアウト不可) | 利用される(オプトアウト不可) |
Gemini 1.5 Proの無料枠は1分間に2リクエスト、1日に50リクエストまでしか送信できないため、複数人が同時にアクセスする環境や連続したテストでは即座に上限に達します。対してFlashは1日1,500リクエストまで許容されており、小規模な個人開発ツールであれば無料枠の範囲内で稼働し続けることも可能です。
無料枠から有料プラン(Pay-as-you-go)へ切り替えるべき明確な基準は以下の3点です。
- 機密情報や個人情報を含むデータをAPI経由で送信する場合(無料枠では入力データがGoogleのモデル改善や学習に利用される規約となっており、有料プランへ移行することで初めて学習利用から除外されるため)
- Proモデルにおいて1分間に3回以上のリクエスト、または1回あたり32,000トークンを超える長文データを扱う場合
- 不特定多数のユーザーが利用する本番環境にシステムを公開し、レート制限による通信エラーを回避したい場合
プロトタイプの検証段階では無料枠を活用し、社内の実データを用いた検証や本番リリースへ移行するタイミングでGoogle Cloudの請求先アカウントを連携し、有料プランへ切り替えるのが安全な運用手順です。
目的別に見るGemini 1.5 FlashとProの使い分け方
Gemini 1.5 FlashとGemini 1.5 Proをシステム開発や業務効率化で使い分ける際は、対象タスクが求める「応答速度」「処理量」「推論の深さ」の3つの軸で判断します。Googleの公式ドキュメントでも、高頻度で発生する定型タスクにはFlash、高度な推論を伴う汎用タスクにはProが推奨されています。
まずは、業務内容や開発する機能の目的別にどちらのモデルを選択すべきか、判断基準を以下の表で整理します。
| 評価軸・業務目的 | 推奨モデル | 選定の理由と期待できる効果 |
|---|---|---|
| ユーザーを待たせない対話機能の実装 | Gemini 1.5 Flash | 最初の1文字が出力されるまでの時間(TTFT)が短く、ユーザーの離脱を防げるため |
| 1日あたり数万件以上のバッチ処理 | Gemini 1.5 Flash | APIリクエストのレート制限(RPM/TPM)が緩和されており、トークン単価も低く抑えられるため |
| 複数条件が絡み合う論理的思考・企画立案 | Gemini 1.5 Pro | プロンプト内の複雑な制約条件を漏れなく解釈し、破綻のないアウトプットを生成できるため |
| 専門性の高いデータの横断的な解析 | Gemini 1.5 Pro | 長大なコンテキスト内にある微細な相関関係や矛盾点を正確に抽出できるため |
Gemini 1.5 Flashが適している具体的なユースケース
Gemini 1.5 Flashは、推論の深さよりも単位時間あたりの処理件数とレスポンスの速さが優先される実務に適しています。システム全体のランニングコストを抑えながら、実用的な生成精度を維持したい場面で力を発揮します。
チャットボットやリアルタイム応答システム
ECサイトのカスタマーサポート用チャットボットや、社内ヘルプデスクの自動応答システムにはGemini 1.5 Flashが適しています。対話型のインターフェースでは、ユーザーが質問を送信してから回答の表示が始まるまでに数秒以上のラグが生じると、ユーザー体験が大きく損なわれるためです。
特に、社内規定のドキュメントやFAQデータベースから関連情報を検索して回答を生成するRAG(検索拡張生成)の仕組みにおいては、検索結果のテキストを元に自然な日本語へ整える処理が中心となります。このような「すでに答えが含まれている参照データからの回答作成」であれば、高度な推論能力を持つProを使わなくても、Flashで十分に正確な応答が可能です。音声認識と組み合わせたリアルタイムのボイスボットなど、ミリ秒単位の遅延短縮が求められる環境でもFlashが第一選択となります。
大量のテキストデータの要約や分類
日々蓄積される膨大なテキストデータを自動で整理・構造化するバッチ処理においても、Gemini 1.5 Flashの導入が効果的です。アンケート結果の自由記述欄の分析や、ニュース記事のカテゴリ振り分けなど、1件あたりの処理は単純でも母数が数万件にのぼる業務では、Proを使用するとAPI利用料と処理時間が肥大化します。
具体的な活用例として、以下のようなデータ処理タスクが挙げられます。
- コールセンターに寄せられた月間数万件の通話テキストログから、顧客の不満要因を抽出して5段階の緊急度に分類する
- ECサイトに投稿された大量の商品レビューを読み込み、ポジティブ・ネガティブの感情分析(センチメント分析)と改善要望のタグ付けを自動化する
- Web上から収集した競合他社のプレスリリースや業界ニュースをそれぞれ300文字程度に要約し、指定したJSONフォーマットに変換してデータベースへ格納する
これらのタスクは判断基準が明確であり、プロンプトで出力形式(JSONスキーマなど)を指定すれば、FlashでもProと遜色ない精度で高速に処理を完了できます。
Gemini 1.5 Proが適している具体的なユースケース
Gemini 1.5 Proは、単なる情報の抽出や言い換えにとどまらず、与えられた複数の情報から新しい結論を導き出す高度な思考タスクに向いています。1回あたりのAPIコストや数秒の待ち時間を許容してでも、人間が手直しする工数を最小限に抑えたい専門業務で真価を発揮します。
複雑なプログラミングコードの生成とデバッグ
複数のファイルやモジュールが相互に依存している大規模なソフトウェア開発において、新規機能の実装や原因不明のバグ特定を行う場合はGemini 1.5 Proが適しています。単一関数の作成や簡単な構文エラーの修正であればFlashでも対応できますが、システム全体のアーキテクチャを踏まえたコード生成には高度な論理的推論が不可欠だからです。
開発現場でProを選択すべき具体的な条件は以下の通りです。
- レガシーシステムの数万行におよぶソースコード一式を読み込ませ、既存の仕様を壊さずに新しいフレームワークや言語へ移行(リファクタリング)する
- 複数のマイクロサービス間で発生しているエラーログと関連コードを同時に渡し、データの不整合が起きている根本原因を特定して修正パッチを作成する
- セキュリティ要件やパフォーマンスの制約を細かく指定し、エッジケース(例外的な動作環境)まで考慮した堅牢なテストコードを網羅的に生成する
Proは文脈の背後にある設計意図やアルゴリズムの計算量を深く理解するため、手戻りの少ない実用的なコードを一発で出力できる確率が高まります。
長尺の動画や音声データの高度な分析
1時間を超える会議の録画データや、複数の専門書・財務諸表などを丸ごと読み込ませ、多角的な視点から分析レポートを作成するタスクにはGemini 1.5 Proが必要です。大容量のデータを入力できる点自体は両モデルに共通していますが、その膨大なデータの中から「どの情報とどの情報を結びつけて考察すべきか」を判断する能力においてProが優位に立ちます。
たとえば、製品のユーザーインタビュー動画(映像と音声)をそのまま入力し、「発言内容自体は肯定的だが、操作画面が切り替わった瞬間に表情が曇り、操作の手が止まった箇所」を特定するようなマルチモーダル分析が該当します。文字起こしテキストの表面的な要約だけでなく、映像内の視覚的な変化と音声のトーン、さらに事前のアンケート結果といった異なる形式のデータを横断的に照合し、潜在的な課題を推論する作業はProならではの領域です。
また、企業の過去数年分の有価証券報告書(PDF)と決算説明会の音声データを同時に与えて、経営陣の発言の変遷と実際の財務数値の乖離を指摘させるような、アナリストレベルの深い洞察を求める業務でもProの推論性能が求められます。
Gemini 1.5 FlashとProを実際に利用する方法
Gemini 1.5 FlashとProを自社システムや開発プロジェクトで使い分ける場合、Googleが提供する開発者向けプラットフォームを経由してモデルを呼び出します。主な利用環境として、ブラウザ上で手軽にプロンプトの実験やAPIキーの発行ができる「Google AI Studio」と、クラウド基盤上でセキュアにシステムを構築・運用できる「Vertex AI」の2つが用意されています。
個人の検証や初期のプロトタイプ開発にはGoogle AI Studio、商用環境での本格的なシステム運用にはVertex AIというように、開発フェーズや求めるセキュリティ要件に応じて環境を選択するのが一般的です。それぞれの環境における特徴や管理単位の違いは以下の通りです。
| 比較項目 | Google AI Studio | Vertex AI |
|---|---|---|
| 主な用途 | プロトタイプ開発・迅速な動作検証・個人開発 | 商用システムの本番運用・大規模なエンタープライズ開発 |
| 認証・権限管理 | 単一のAPIキーによるシンプルな認証 | Google CloudのIAM(Identity and Access Management)による詳細な権限管理 |
| データの取り扱い | 無料枠では入力データがモデルの学習・改善に利用される場合がある | 顧客データはGoogleの基盤モデルの学習に利用されない規約が適用される |
| インフラ連携 | 外部アプリからのAPI呼び出しに特化 | BigQueryやCloud Storageなど他のGoogle Cloud製品と直接連携可能 |
Google AI Studioでのモデル切り替えとテスト手順
Google AI Studioは、Googleアカウントがあればクレジットカードの登録なしで即座に利用できるWebベースの開発環境です。画面上でGemini 1.5 FlashとProをリアルタイムに切り替えながら、同じプロンプトに対する応答速度や出力品質の差を直接比較できます。
実際にGoogle AI Studio上でモデルを切り替え、テストからコード出力までを行う手順は以下の通りです。
- GoogleアカウントでGoogle AI Studioにログインし、画面左側のメニューから「Create new prompt(新規プロンプトの作成)」を選択します。
- 画面右側の設定パネル(Run settings)上部にある「Model」のプルダウンメニューをクリックし、「Gemini 1.5 Flash」または「Gemini 1.5 Pro」を選択します。
- 必要に応じて、出力の多様性を調整する「Temperature(温度)」や最大出力トークン数などのパラメータを調整します。
- 画面中央の入力欄にテストしたいテキストや画像、動画ファイルを入力し、「Run」ボタンをクリックして出力結果と生成にかかった秒数を確認します。
- 検証が完了したら、画面右上の「Get code」をクリックし、PythonやJavaScript(Node.js)、cURLなど任意のプログラミング言語の実装コードを取得します。
また、Google AI Studioの「Compare mode(比較モード)」機能を使用すると、画面を左右に分割して片方にGemini 1.5 Flash、もう片方にGemini 1.5 Proを設定し、同一のプロンプトを同時に実行できます。プロンプトに対する両モデルの回答内容と生成時間を一画面で並べて検証できるため、要件を満たす最小限のモデルを見極める作業が効率化します。
外部のアプリケーションから呼び出す場合は、画面左上の「Get API key」からAPIキーを発行します。取得したサンプルコード内のモデル指定部分(例:gemini-1.5-flashやgemini-1.5-pro)を書き換えるだけで、プログラム側でも即座にモデルの切り替えが可能です。
Vertex AIを活用した企業向けシステムへの導入方法
社内データを扱う業務システムや、顧客向けに提供する商用サービスにGemini 1.5を組み込む場合は、Google CloudのVertex AIを利用します。Vertex AIを経由してモデルを利用する最大の利点は、エンタープライズ向けの厳格なセキュリティとデータガバナンスが適用される点にあります。
企業のシステム導入においてVertex AIが選ばれる具体的な機能と条件は以下の通りです。
- 入力したプロンプトや出力結果がGoogle側の基盤モデルのトレーニングに一切使用されないことがサービス規約で保証されている
- VPC Service Controlsに対応しており、仮想プライベートクラウド内の閉域網通信によって情報漏洩リスクを最小化できる
- IAMによるロールベースのアクセス制御により、開発者や部署ごとに利用可能なモデルや機能を制限できる
- 企業の独自データや社内ドキュメントを検索して回答を生成するグラウンディング(RAG:検索拡張生成)機能を標準搭載している
Vertex AIでモデルを導入する際は、まずGoogle Cloudコンソールでプロジェクトを作成し、課金設定とVertex AI APIの有効化を行います。コンソール内の「Vertex AI Studio」を開けば、Google AI Studioと同様にGUI上でGemini 1.5 FlashとProの動作をテストできます。
本番のアプリケーションへ組み込む際は、Google Cloud SDKをシステム環境にインストールし、サービスアカウントを用いた認証を設定します。APIリクエストを送信するエンドポイントやSDKの初期化コードにおいてモデルIDを指定しますが、両モデルは共通のAPIインターフェースで設計されているため、システムの基本構造を変えることなくモデル名を変更するだけでFlashとProを切り替えられます。
さらに、Vertex AIでは特定のタスク向けにモデルを最適化するファインチューニング(教師ありチューニング)や、定常的な大量リクエストに対して処理能力を事前に確保する「プロビジョンドスループット」の契約も可能です。これにより、アクセス集中時でも通信遅延のない安定したシステム運用を実現できます。
よくある質問(FAQ)
Gemini 1.5 FlashとProは日本語の精度に違いはありますか?
基本的な日本語の読み書きや日常的なビジネス文章の生成において、両モデルともに高い精度を備えており、一般的な定型業務では大きな差を感じにくくなっています。ただし、日本語特有の曖昧な表現の解釈や、高度な文脈理解が求められるタスクでは、パラメータ数が多く推論能力に優れるGemini 1.5 Proのほうがより自然で的確な出力を行います。
具体的には、小説の執筆、キャッチコピーの考案、複雑な敬語表現が絡むビジネスメールの作成、あるいは古典や専門的な法律文書の読解などでは、Proのほうが文脈の背後にある意図を正確に汲み取ります。一方で、ニュース記事の要約、定型フォーマットへのデータ抽出、一般的なカスタマーサポートの応答といった処理であれば、Gemini 1.5 Flashでも遜色のない自然な日本語を出力できます。
コンテキストウィンドウの最大トークン数に違いはありますか?
はい、一度に処理できるデータ量を示すコンテキストウィンドウの最大トークン数には明確な違いがあります。Google AIの公式ドキュメント(Gemini Models | Google AI for Developers)で定義されているとおり、Gemini 1.5 Flashが最大100万トークンであるのに対し、Gemini 1.5 Proは最大200万トークンまで対応しています。
それぞれの最大トークン数で処理できるデータ量の目安は以下のとおりです。
| 比較項目 | Gemini 1.5 Flash | Gemini 1.5 Pro |
|---|---|---|
| 最大トークン数 | 100万トークン | 200万トークン |
| 日本語テキストの目安 | 約70万〜100万文字(新書約7〜10冊分) | 約140万〜200万文字(新書約14〜20冊分) |
| 動画データの目安 | 約1時間 | 約2時間 |
| 音声データの目安 | 約11時間 | 約22時間 |
| プログラムコードの目安 | 約3万行以上 | 約6万行以上 |
100万トークンでも他社の主要モデルと比較して非常に大きな容量ですが、長編映画1本分の動画解析や、大規模なシステム全体のソースコードを一括で読み込ませるようなケースでは、200万トークンを扱えるGemini 1.5 Proが適しています。
スマホアプリやWeb版のGeminiではどちらのモデルが使われていますか?
一般ユーザー向けのブラウザ版(gemini.google.com)やスマートフォンアプリ版のGeminiでは、契約しているプランによって適用されるモデルが異なります。
- 無料版(標準のGoogleアカウント):応答速度に優れたGemini 1.5 Flashが標準搭載されており、日常の検索補助やテキスト作成を素早く行えます。
- 有料版(Google One AI プレミアムプラン等):高度な推論が可能なGemini 1.5 Proが適用され、複雑なデータ分析や長文ファイルの読み込みが可能になります。
法人向けのGoogle Workspace拡張機能として提供されているGeminiでも、契約するアドオンのエディションによって利用可能なモデルや機能が制御されています。なお、Web版やスマホアプリのUIはGoogleのアップデートによって随時更新されるため、画面上のモデル選択メニューから現在稼働しているモデルを確認できます。
OpenAIのGPT-4oやGPT-4o miniと比較するとどのような位置付けですか?
OpenAIが提供する主要モデルと比較した場合、性能とコストのバランスから、それぞれのモデルが直接的な競合関係にあります。
| モデルの分類 | Google(Geminiシリーズ) | OpenAI(GPTシリーズ) | 主な位置付けと特徴 |
|---|---|---|---|
| 軽量・高速モデル | Gemini 1.5 Flash | GPT-4o mini | 低コスト・低遅延を重視。大量データの処理やチャットボットなど、高頻度のAPI呼び出しに最適。 |
| 上位・高性能モデル | Gemini 1.5 Pro | GPT-4o | 高度な推論・精度を重視。複雑なプログラミング、専門的な分析、マルチモーダルな高度処理に最適。 |
GPT-4oシリーズに対するGemini 1.5シリーズの明確な差別化要因は、コンテキストウィンドウの広さとネイティブなマルチモーダル処理能力です。GPT-4oおよびGPT-4o miniの最大入力トークン数が12万8,000トークンであるのに対し、Gemini 1.5シリーズは100万〜200万トークンを誇ります。そのため、外部データベースを検索するRAG(検索拡張生成)の仕組みを構築することなく、大量のPDF資料や長尺の動画ファイルを直接プロンプトに投入して分析させる用途においては、Geminiシリーズが優位に立ちます。
システムの途中でFlashからProへモデルを変更することは簡単ですか?
はい、Google AI Studio(Gemini API)やVertex AIを利用してシステムを構築している場合、コード内のモデル指定文字列(モデルID)を書き換えるだけで簡単に変更できます。
APIのリクエスト構造やパラメータの仕様は両モデルで共通化されているため、システム全体の設計をやり直す必要はありません。たとえば、PythonのSDKを使用している場合、GenerativeModel("gemini-1.5-flash")と記述している部分をGenerativeModel("gemini-1.5-pro")に変更するだけで切り替えが完了します。
ただし、運用中のシステムでモデルを切り替える際は、以下の点に注意して事前テストを行う必要があります。
- プロンプトの調整:モデルによって指示の解釈の仕方や出力の傾向が微妙に異なるため、特にProからFlashへダウングレードする場合は、出力フォーマットが崩れないかプロンプトの微調整が必要です。
- レート制限(RPM/TPM)の確認:1分あたりのリクエスト数(RPM)やトークン数(TPM)の上限は、Flashのほうが広く設定されており、Proに変更すると制限に達しやすくなる場合があります。
- タイムアウト設定の見直し:FlashからProへ変更すると応答までの時間(レイテンシ)が長くなる傾向があるため、システム側の通信タイムアウト時間を長めに再設定する必要があります。
この切り替えの手軽さを活かし、普段の定型処理はFlashでコストを抑えつつ、ユーザーの質問が複雑な場合やエラーが発生した場合のみProへ動的にルーティングするようなハイブリッド構成も容易に実装できます。
まとめ
本記事では、Gemini 1.5 FlashとProの性能差や料金体系、目的別の使い分け方を解説しました。
- Gemini 1.5 Flash:低コストかつ高速な処理に優れ、チャットボットや大量データの要約・分類に適している
- Gemini 1.5 Pro:高度な推論能力を持ち、複雑なプログラミングや長尺動画の分析に適している
- 共通機能:テキスト・画像・音声・動画を同時に扱うマルチモーダル性能と、長大なコンテキストウィンドウを備える
開発するシステムの要件や予算に合わせてモデルを選択することで、APIの運用コストを抑えつつ処理精度を高められます。まずはGoogle AI Studioの無料枠を活用し、両モデルの応答速度と出力精度を実際に比較してみましょう。