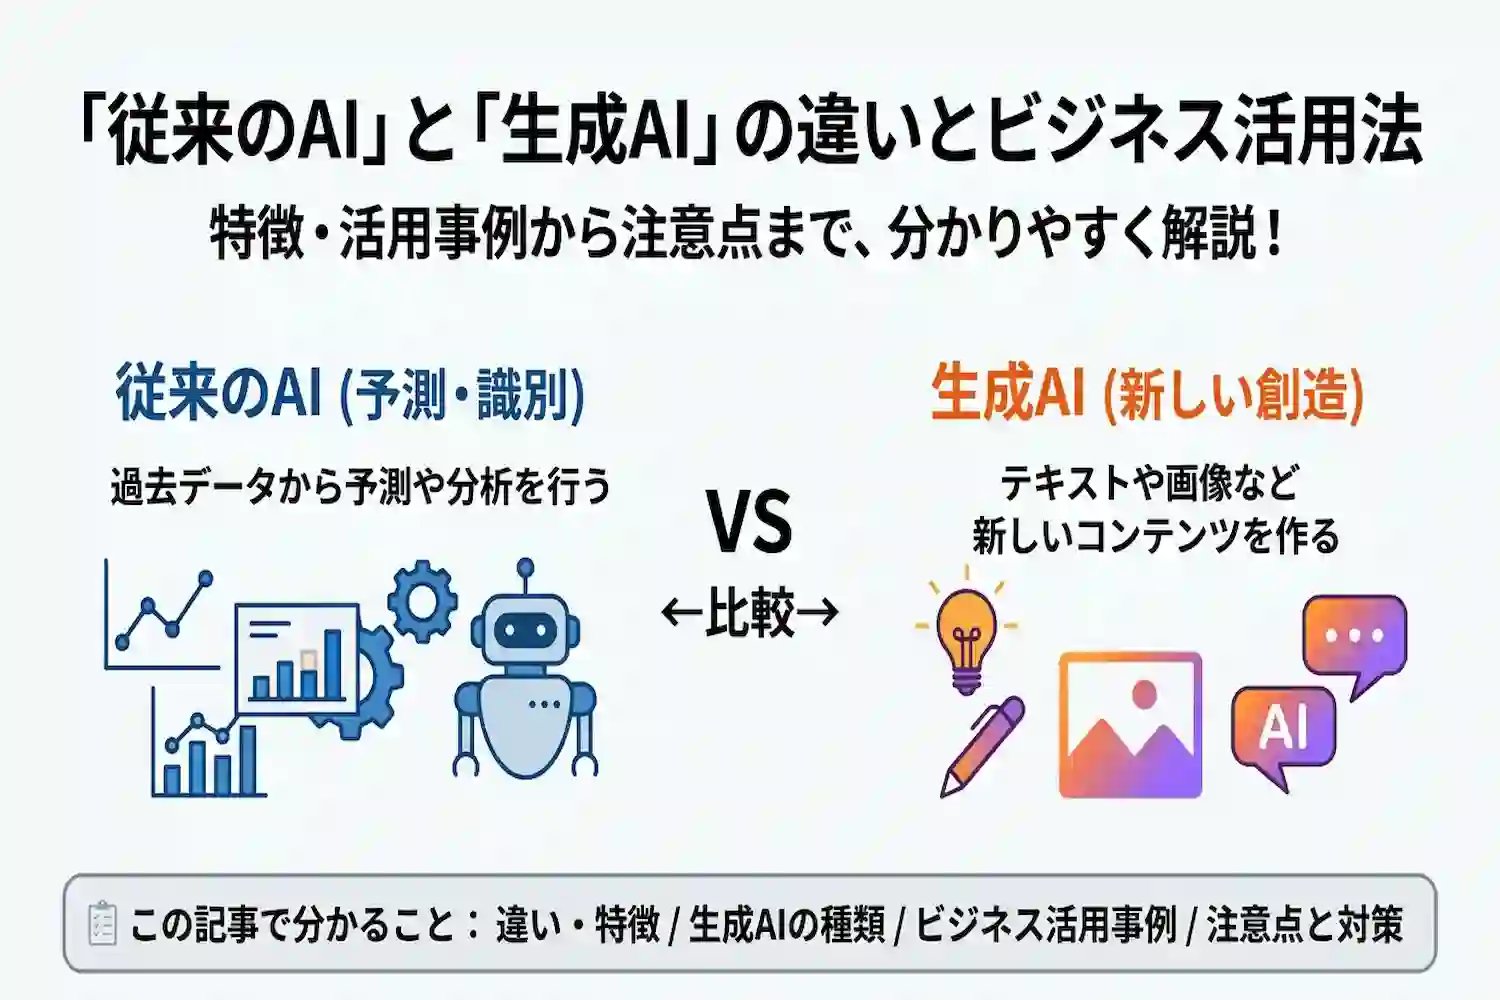
従来のAIは過去のデータから予測や識別を行う技術であるのに対し、生成AIはテキストや画像など新しいコンテンツを創り出す技術です。AIという大きな枠組みの中に、ディープラーニングを発展させた生成AIが含まれます。
この記事で分かること
- 従来のAI(予測・識別)と生成AI(創造)の役割や出力結果の違い
- ChatGPTやMidjourneyなど生成AIの種類と特徴
- 需要予測や文章作成などビジネスでの活用事例
- ハルシネーションや著作権侵害、情報漏洩への対策
業務の自動化には従来のAI、企画立案やコンテンツ制作には生成AIと、目的に応じて使い分けることで業務効率化が進みます。なお、サービスの提供状況や料金は変わりやすいため、本記事は2026年11月時点の情報に基づいています。導入前に各社の公式情報をご確認ください。
生成AIとAIの違いをわかりやすく解説
生成AIと従来のAI(人工知能)の最も大きな違いは、蓄積されたデータをもとに「既存の選択肢から判定・予測するか」「新しいコンテンツをゼロから創り出すか」という点にあります。両者はまったく別の技術ではなく、AIという広い概念の中に生成AIが含まれています。
まずは両者の基本的な定義と特徴の全体像を以下の表で確認してください。
| 比較項目 | 従来のAI(識別系・予測系AI) | 生成AI(ジェネレーティブAI) |
|---|---|---|
| 主な役割 | データの分類・識別・数値の予測 | 新しいオリジナルコンテンツの生成 |
| 得意な処理 | ルールや過去のデータに基づく正解の判定 | 文脈の理解と、過去にない表現の創造 |
| 身近な例 | スマートフォンの顔認証、ECサイトのレコメンド | 対話型チャットサービス、イラスト自動生成ツール |
従来のAI(人工知能)とはデータを分析して予測・識別する技術
従来のAIは、あらかじめ設定されたルールや学習した膨大なデータから法則性を見つけ出し、目の前のデータが何であるかを「識別」したり、将来の数値を「予測」したりする技術です。専門的には「識別系AI」や「予測系AI」とも呼ばれます。
従来のAIは、与えられたデータの中から条件に合致する答えを探し出す処理を行います。すでに日常生活やビジネスの現場に深く浸透している代表的な機能は以下の通りです。
- スマートフォンのロックを解除する顔認証システム
- メールソフトで不審なメールを自動で振り分けるスパムフィルター
- ECサイトで過去の購入履歴から「あなたへのおすすめ商品」を表示するレコメンド機能
- スマートスピーカーが人間の呼びかけを聞き取る音声認識機能
これらのシステムは、過去のデータを基準にして「本人か他人か」「スパムか通常のメールか」を瞬時に判定しています。このように、既存の選択肢やデータ群の中から最も確からしい答えを導き出すのが従来のAIの基本機能です。
生成AI(ジェネレーティブAI)とは新しいコンテンツを創り出す技術
生成AI(ジェネレーティブAI)は、学習した大量のデータの特徴や構造を応用し、これまでに存在しなかった新しいテキスト、画像、動画、音声、プログラムコードなどを創り出す技術です。
従来のAIが「データの中から正解を選ぶ」のに対し、生成AIは人間が入力した指示(プロンプト)の文脈を解釈し、要素を組み合わせてオリジナルの表現を出力します。総務省の情報通信白書でも、データ分析を目的とする従来型のAIと、情報を生成・創造する生成AIは区別して説明されています。
たとえば、従来のAIに「犬と猫の画像」を学習させた場合、新しい画像を見せたときに「これは犬である」と判定します。一方、生成AIに同じデータを学習させた場合は、「帽子をかぶって走る犬のイラストを描いて」という指示に対して、学習した犬の特徴と帽子の特徴を掛け合わせ、世の中にまだ存在しない新しい画像をその場で描き出します。
AIという大きな枠組みの中に生成AIが含まれる関係性
「AI」と「生成AI」は対立する別個の技術ではなく、AIという大きな技術分野の一部として生成AIが存在する包含関係にあります。技術の階層構造を整理すると、以下のようになります。
- AI(人工知能):人間の知的な振る舞いをコンピューターで再現する技術全般
- 機械学習(マシンラーニング):AIの手法の一つで、コンピューターがデータから反復的にパターンを学ぶ技術
- 深層学習(ディープラーニング):機械学習をさらに発展させ、人間の脳神経回路を模したモデルで複雑な特徴を自動で抽出する技術
- 生成AI(ジェネレーティブAI):ディープラーニングの技術を応用し、データの生成に特化して発展した技術
つまり、生成AIも広義の「AI」の一つです。ただし、ビジネスやニュースの文脈で「AIと生成AIの違い」と表現される場合は、ディープラーニング登場以前から使われている「識別・予測を行う従来のAI」と、近年急速に普及した「創造を行う生成AI」を区別して比較するケースが一般的です。
生成AIと従来のAIの違いを3つの視点で比較
生成AIと従来のAI(識別系AI・予測系AI)は、どちらも人工知能という同じ技術領域に属していますが、システムとしての設計思想や得意とする処理が大きく異なります。両者の違いを明確にするため、「役割と目的」「学習データとディープラーニングの活用方法」「出力される結果」という3つの視点から比較します。
| 比較の視点 | 従来のAI(識別系・予測系) | 生成AI(ジェネレーティブAI) |
|---|---|---|
| 役割と目的 | 既存データの分類・識別・数値予測・自動化 | 新しいコンテンツ(文章・画像・音声・コードなど)の創造 |
| 学習と技術の特徴 | 特定タスク向けの教師あり学習が中心(正解ラベル付きデータの学習) | 大規模な自己教師あり学習と基盤モデル(データの構造や文脈の確率的学習) |
| 出力される結果 | 事前に定義された選択肢からの判定結果や予測値(単一の正解を目指す) | プロンプト(指示文)に応じた多様な新規表現(唯一無二の正解がない) |
役割と目的の違い(識別・予測か創造か)
従来のAIと生成AIにおける根本的な違いは、システムに与えられた「役割と目的」にあります。従来のAIは「すでにあるデータの中から規則性を見つけ出し、分類・識別・予測を行うこと」を目的としているのに対し、生成AIは「学習したパターンをもとに、世の中にまだ存在しない新しいデータをゼロから創り出すこと」を目的としています。
従来のAIは、人間が設定した特定の業務プロセスを正確に高速化・自動化するために設計されています。入力されたデータに対して「AであるかBであるか」を判定したり、過去の推移から「将来の数値」を計算したりする役割を担います。
- スパムメールの振り分け:受信したメールの文面や送信元データを分析し、「通常メール」か「迷惑メール」かを識別する
- 顔認証システム:カメラに映った人物の顔の特徴点を抽出し、登録済みのデータベースと照合して本人かどうかを判定する
- 売上・需要の予測:過去の販売実績や天候、曜日などの変数から、翌月の商品の売上個数を算出する
一方、生成AIの役割はコンテンツの「創造(生成)」です。過去のデータを分析するだけでなく、そこから得た知識を応用して、人間が書いたような自然なテキストや、プロが描いたようなイラスト、さらにはプログラムのソースコードなどを新規に構築します。判定や予測にとどまらず、人間の思考や創作活動を直接的に補助・代行する点が生成AIの主目的です。
学習データとディープラーニングの活用方法の違い
2つ目の違いは、AIの頭脳を作るための「機械学習(マシンラーニング)およびディープラーニング(深層学習)のアプローチ」と「学習データの扱い方」です。
従来のAIでは、主に特定のタスクに特化した「教師あり学習」が用いられてきました。これは、人間があらかじめ「入力データ」と「正解ラベル」をセットにした学習データを用意し、AIに反復学習させる手法です。たとえば、犬と猫を見分けるAIを作る場合、大量の犬の画像に「犬」、猫の画像に「猫」という正解タグを手動で付与して学習させます。ディープラーニングを活用する場合でも、「画像内のどこに特徴があるか(輪郭や耳の形など)」を抽出して分類の境界線を引くためにニューラルネットワークが使われます。そのため、犬と猫を識別するAIに、突然「鳥の画像」を分類させたり、犬の絵を描かせたりすることはできません。
これに対し、生成AIはインターネット上にある膨大なテキストや画像などを活用し、正解ラベルを人間が一つひとつ付与しない「自己教師あり学習」などの手法で事前学習を行います。この大規模なデータ学習によって構築された汎用的なAIモデルは「基盤モデル(ファウンデーションモデル)」と呼ばれます。とくにテキストなどを扱う大規模言語モデル(LLM)では、ディープラーニングの「Transformer(トランスフォーマー)」と呼ばれる深層学習アーキテクチャが採用されており、データ内の単語やピクセルの前後関係・文脈・構造を確率的に学習しています。
つまり、従来のAIが「特定の課題に対する正解の境界線」を学習しているのに対し、生成AIは「データ全体の構造や、ある要素の次に何が来るかという確率分布」をディープラーニングによって学習しています。この学習方法の違いにより、生成AIは1つのモデルでありながら、翻訳、要約、質疑応答、創作といった複数の異なるタスクに柔軟に対応できます。
出力される結果の違い(正解があるか新しい表現か)
3つ目の違いは、AIが処理を終えたあとに「出力される結果(アウトプット)の性質」です。従来のAIの出力には明確な「正解・不正解」の基準が存在しますが、生成AIの出力は新しい表現であるため「単一の正解が存在しない」という特徴があります。
従来のAIが出力するのは、あらかじめ決められた枠組みの中の数値や判定ラベルです。たとえば、「不良品の検知AI」であれば出力は「正常」か「異常」の2択であり、「株価の予測AI」であれば特定の予測数値が出力されます。同じ入力データを与えれば、原則として毎回同じ結果が出力され、その結果が正しかったかどうかを客観的なデータ(実際の不良品の有無や実際の株価)と照らし合わせて、精度を評価することができます。
一方、生成AIはユーザーからのプロンプト(指示文)を受け取り、学習した確率分布に基づいて、その場で要素を組み合わせて結果を出力します。たとえば、「新商品のキャッチコピーを5つ考えて」と指示した場合、AIは毎回異なる表現のテキストを生成します。そこには数学的な「唯一の正解」はなく、出力された表現が優れているかどうかは、利用する人間の主観や文脈、目的に合致しているかによって評価されます。
生成AIと従来のAIの出力結果における具体的な違いは以下の通りです。
- 出力の再現性:従来のAIは同じ入力に対して常に同じ判定結果を返すが、生成AIは確率的に要素を選択するため、同じプロンプトでも実行するたびに異なる表現を出力することがある
- 出力の形式:従来のAIは「クラス分類(AかBか)」「確率(85%など)」「予測値(1,200個など)」といった定型データを出力するが、生成AIは長文のレポート、高解像度の画像、自然な会話音声といった非定型のコンテンツを出力する
- エラーの性質:従来のAIの誤りは「予測の外れ」や「誤判定(見落とし)」として現れるが、生成AIの誤りは事実と異なる情報をあたかも事実のように出力する現象や、文脈の破綻として現れる
このように、確実な判定や数値の算出が求められる場面では従来のAIの出力が適しており、多様なアイデアの創出やドラフト(下書き)の作成が求められる場面では生成AIの出力が適しています。
生成AIの主な種類と代表的なサービスの特徴
生成AIは出力するコンテンツの形式によって「テキスト」「画像」「動画」「音声・音楽」の4種類に大きく分けられます。利用者が「プロンプト」と呼ばれる指示文や参考データを入力すると、それぞれのメディア形式に応じた新しいデータが生成される仕組みです。単一の形式だけでなく、テキスト・画像・音声などを同時に処理できるマルチモーダル対応のサービスも普及しています。
| 生成AIの種類 | 生成できるコンテンツ | 代表的なサービス |
|---|---|---|
| テキスト生成AI | 文章、要約、翻訳、プログラムコード | ChatGPT、Claude、Gemini |
| 画像生成AI | イラスト、写真風画像、デザイン素材、ロゴ | Midjourney、Stable Diffusion、Adobe Firefly |
| 動画生成AI | ショート動画、アニメーション、実写風映像 | Runway、Google Veo、Kling |
| 音声・音楽生成AI | ナレーション音声、ボーカル曲、BGM、効果音 | Suno、VOICEVOX、ElevenLabs |
テキスト生成AI(ChatGPTやClaudeなど)
テキスト生成AIは、大規模言語モデル(LLM)を基盤としており、人間が使う自然な言葉(自然言語)を理解してテキストを出力します。膨大なテキストデータから単語の並び方や文脈のパターンを学習しており、質問に対する回答だけでなく、条件を指定した文章の作成や変換が可能です。
代表的なサービスには、以下のようなものがあります。
- ChatGPT(OpenAI社):テキストの対話だけでなく、Web検索、画像認識、データ分析などを1つの画面で行える汎用性の高いサービスです。
- Claude(Anthropic社):長文の読み込みや文章作成、コーディングなどで使われています。自然な日本語表現に強みがあるという声もありますが、これは主観的な評価です。
- Gemini(Google社):GoogleドキュメントやGmailなどのGoogle Workspace製品と連携でき、Google検索の結果をもとにした情報収集やテキスト作成が可能です。
これらのツールにプロンプトを入力することで、長文レポートの要約や多言語への翻訳、プログラミングコードの生成・修正を数秒で完了できるようになります。指定した文字数やトーン(丁寧語、箇条書きなど)に合わせた出力調整も容易です。
画像生成AI(MidjourneyやStable Diffusionなど)
画像生成AIは、入力されたテキストの指示やベースとなる画像をもとに、新しいイラストや写真風の画像を出力する技術です。主に「拡散モデル(Diffusion Model)」と呼ばれる技術が使われており、ノイズだけの画像から少しずつ意味のある形を浮かび上がらせることで、高精細なビジュアルを描き出します。
代表的なサービスごとの特徴は以下の通りです。
- Midjourney(Midjourney社):簡単な英単語や文章を入力するだけで、芸術性が高く細部まで描き込まれたイラストやリアルな写真風画像を生成できます。
- Stable Diffusion(Stability AI社):モデルが公開されており、自分のパソコンに導入して画像を生成したり、特定の画風やポーズを追加学習させたりするカスタマイズが可能です。利用できる範囲はモデルごとのライセンス条件で異なるため、商用利用の前に確認してください。
- Adobe Firefly(Adobe社):PhotoshopやIllustratorなどのデザインソフトに組み込まれており、画像の足りない背景を自然に描き足す「生成塗りつぶし」や、不要な対象物の消去を直感的に行えます。
画像生成AIでは、被写体だけでなく「水彩画風」「一眼レフカメラで撮影したような背景ボケ」「夕暮れの逆光」といった画風や照明条件まで言葉で細かく指定できます。これにより、専門的な描画スキルや撮影機材がなくても、企画書用のイメージ図やWeb広告の素材を短時間で作成できるのが特徴です。
動画生成AI(RunwayやGoogle Veoなど)
動画生成AIは、テキストの指示(Text-to-Video)や1枚の静止画(Image-to-Video)から、動きのある映像データを生成します。単に前後のフレームを繋ぎ合わせるだけでなく、光の反射や物体の動きといった現実に近い映像表現を生み出す技術が実用化されています。
この分野は入れ替わりが激しく、たとえばOpenAIの動画生成サービス「Sora」は、2026年3月に終了が発表され、Webアプリ版は同年4月26日、API版は同年9月24日に提供を終了したと報じられています。現在は、次のようなサービスが比較対象に挙がります(提供状況や機能は変わりやすいため、各社の公式情報で確認してください)。
- Runway(Runway社):動画生成モデルを提供しており、2025年12月には「Gen-4.5」が公開されたと報じられています。
- Google Veo(Google社):Googleが提供する動画生成モデルです。
- Kling(Kuaishou社):中国の快手が提供する動画生成モデルです。
動画生成AIを利用すると、手元にある商品写真の背景にだけ波や風の動きをつけたり、「ドローンで空撮したような映像」をテキスト指示だけで出力したりできます。従来の映像制作で必須だったロケ撮影や3DCGのモデリング工程を経ずに、数秒から数十秒の映像クリップを直接出力できる点が大きな特徴です。
音声・音楽生成AI(SunoやVOICEVOXなど)
音声・音楽生成AIは、人間の話し声を合成する「音声合成(Text-to-Speech)」と、メロディ・伴奏・歌声を含めた楽曲を作り出す「音楽生成」の2つの領域に分かれます。音声の波形データや楽曲の構造(コード進行、リズム、楽器の音色)を学習しており、文脈に合った抑揚や指定した音楽ジャンルを再現します。
それぞれの領域で広く使われている代表的なサービスは以下の通りです。
- Suno(Suno社):歌詞と曲調(J-POP、ジャズ、アコースティックなど)をテキストで入力するだけで、人間のボーカルと楽器の伴奏が入った楽曲を自動で生成します。
- VOICEVOX:テキストを入力すると多様なキャラクターの声で読み上げる日本発の無料ソフトウェアで、アクセントやイントネーション、話す速度を調整できます。キャラクターごとの利用規約があるため、公開・商用利用の前に確認してください。
- ElevenLabs(ElevenLabs社):感情の起伏まで再現した自然な多言語ナレーションを生成でき、特定の人物の声質を複製するボイスクローン機能も備えています。
これらのサービスを活用することで、楽器の演奏や作曲の知識がなくても動画のオリジナルBGMを作成したり、録音スタジオや声優を手配せずに解説動画や音声ガイドのナレーションデータを準備したりできます。なお、生成物の商用利用の可否は、サービスや契約プランごとの規約で異なります。
ビジネスにおける従来のAIと生成AIの活用事例
ビジネス現場では、解決したい課題の性質に応じて従来のAIと生成AIが使い分けられています。過去のデータから規則性を見つけて特定の作業を自動化したい場合は従来のAIが選ばれ、ゼロからたたき台を作ったり非定型な業務を補助したりする場合は生成AIが導入されています。
それぞれの技術が実際の業務でどのように機能し、どのような成果をもたらしているのか、具体的な事例を見ていきましょう。
従来のAIの活用事例(需要予測や異常検知)
従来のAI(識別系AI・予測系AI)は、蓄積された膨大な数値データや画像データを分析し、人間では見落としがちなパターンを特定する業務で高い精度を発揮します。事前に定義されたルールや正解データに基づいて判断を下すため、判断基準が明確な定型業務の自動化や精度向上に直結するのが特徴です。
| 活用領域 | 具体的な業務内容 | 導入による業務の変化・効果 |
|---|---|---|
| 小売・流通業における需要予測 | 過去の売上データ、気象情報、曜日、近隣のイベント情報などを掛け合わせ、日別の商品発注数を算出する。 | ベテラン担当者の勘や経験への依存を減らし、食品の廃棄ロス削減や欠品による機会損失の防止が期待できる。 |
| 製造業における外観検査・異常検知 | 工場の生産ラインを流れる製品のカメラ映像を解析し、微細な傷や印字のズレをリアルタイムで判定する。 | 目視検査にかかる人員コストを削減し、人間の疲労による見落としを防いで品質の均一化を図れる。 |
| 金融業における不正利用検知 | クレジットカードの決済履歴や利用場所、金額のパターンを高速で分析し、普段と異なる不審な取引を検出する。 | 第三者による不正利用の早期発見につながり、監視業務の負担を軽減できる。 |
このように従来のAIは、特定のタスクに特化して「イエスかノーか」「数値がいくつになるか」を正確に導き出す場面で企業の基幹システムに深く組み込まれています。
生成AIの活用事例(文章作成やアイデア出し)
生成AIは、自然言語での指示(プロンプト)に応じて新しいテキストや画像、プログラムコードなどを柔軟に出力できるため、これまで自動化が難しかった非定型業務やクリエイティブな領域で急速に普及しています。総務省の令和6年版情報通信白書の企業向けアンケートでは、日本企業のうち「メールや議事録、資料作成等の補助」に生成AIを業務で使用していると回答した割合は46.8%でした。海外の企業と比べると低い水準で、日本企業は社内向け業務から慎重に導入を進めていると分析されています。
具体的な業務での活用パターンは以下の通りです。
- カスタマーサポートにおける返信文案の自動作成:顧客からの問い合わせメールの内容を読み込ませ、社内の対応マニュアルに沿った丁寧な返信文のドラフトを短時間で作成する。担当者は内容の事実確認と微調整を行うだけで済み、1件あたりの対応時間の短縮が期待できる。
- 会議の議事録作成とタスク抽出:録音データから文字起こしされたテキストを入力し、議論の要約、決定事項、担当者ごとのネクストアクションを整理して出力させる。
- マーケティング施策の壁打ちとキャッチコピー案の創出:新商品のターゲット層や特徴を入力し、プロモーション企画の切り口やSNS投稿用のキャッチコピーを複数パターン提案させる。企画会議前のたたき台として活用できる。
- システム開発におけるコード生成とデバッグ補助:実装したい処理内容を日本語で指示してプログラムコードの雛形を出力させたり、エラーが発生したコードを入力して原因の特定と修正案の提示を求めたりすることで、エンジニアの実装を補助する。
生成AIは最終的な成果物を一発で完成させるというよりも、人間がゼロから考える手間を省き、たたき台を瞬時に用意するアシスタントとして機能しています。
従来のAIと生成AIを組み合わせた最新の業務効率化事例
近年では、従来のAIが持つ「正確な分析・予測能力」と、生成AIが持つ「自然な表現・対話能力」を連携させることで、単独の技術では解決できなかった複雑な業務プロセスを一気通貫で自動化する取り組みが進んでいます。以下は、連携の考え方を示す例です。
- 需要予測データに基づく発注理由のレポート自動作成と販促提案:従来のAIが過去の販売データから来週の店舗別売上予測と推奨発注数を算出します。そのままでは現場の店舗スタッフは「なぜこの数値になったのか」が分からず納得感を持てませんが、ここに生成AIを組み合わせることで、天候や周辺イベントなどの予測根拠を自然な文章で解説するレポートを自動生成できます。さらに、需要が高まると予測された商品に合わせた店内POPのキャッチコピー案まで同時に出力できます。
- コールセンターにおける感情分析とリアルタイム回答支援の連携:顧客との通話音声を従来のAI(音声認識および感情解析AI)がリアルタイムで分析し、問い合わせのカテゴリーや感情の変化を特定します。その結果をきっかけに、生成AIが社内データベースから解決策を検索・要約し、顧客の感情に配慮したトークスクリプトをオペレーターの画面に表示します。新人オペレーターの応対を支援する仕組みです。
- 製造ラインの異常検知から保守報告書・対応手順書の自動生成:工場のセンサーデータを監視する従来のAIが設備の異常な振動や温度上昇を検知した際、生成AIが過去の類似トラブルの保守記録を検索します。その上で、「推測される故障原因」「推奨される点検手順」「関係部署への報告メールの文面」をセットで作成し、保全担当者に通知します。異常の発見から初動対応までの時間短縮が期待できます。
このように、データの厳密な処理は従来のAIに任せ、人間が理解しやすい形への変換やコミュニケーション部分を生成AIが担うという役割分担が、ビジネス活用の実践的な考え方になっています。
生成AIをビジネスで活用する際のリスクと注意点
生成AIは業務効率を向上させる一方で、従来のAI(識別系・予測系AI)にはなかった固有のリスクを伴います。従来のAIはあらかじめ決められたルールや限定されたデータセットの範囲内で数値を予測・分類しますが、生成AIは確率論に基づいて新しいコンテンツをゼロから構築するため、出力結果のコントロールが難しい側面があります。企業が実務に導入する際は、以下に示す3つの主要なリスクと対策を把握しておく必要があります。
| リスクの種類 | 発生する主な原因 | ビジネスにおける具体的な影響 | 基本的な対策 |
|---|---|---|---|
| ハルシネーション | 確率的に繋がりの良い単語や要素を並べる仕組みであり、事実確認を行っていないため | 誤情報に基づく経営判断のミス、誤った内容の外部発信による信用失墜 | 人間によるファクトチェックの徹底、RAG(検索拡張生成)の導入 |
| 著作権・商用利用トラブル | 生成物が他者の著作物と類似し、既存の著作物に依拠したと評価されることがあるため | 権利者からの差し止め請求、損害賠償請求、炎上によるブランド毀損 | 類似性・依拠性の確認、商用利用可能なツールの選定 |
| 機密情報・個人情報の漏洩 | サービスによっては、入力したプロンプト(指示文)がAIモデルの機械学習に利用されることがあるため | 社外秘データの流出、個人情報保護法違反、取引先との契約違反 | オプトアウト設定の適用、法人向けプランや専用環境の導入 |
ハルシネーション(もっともらしい嘘)への対策
ハルシネーションとは、生成AIが事実とは異なる内容や文脈と無関係な情報を、あたかも事実であるかのように出力する現象です。テキスト生成AIは「質問に対する正解」を検索して提示しているのではなく、学習データをもとに「次に来る確率が最も高い単語」を繋ぎ合わせて文章を作成しています。そのため、学習データにない最新情報や専門性の高い分野について質問すると、実在しない統計データや架空の判例、誤った歴史的事実などを自然な文章で生成することがあります。
ビジネス現場でハルシネーションによる被害を防ぐには、生成AIの出力結果をそのまま最終成果物として使用せず、人間が一次情報(公的機関の統計や公式発表など)と照らし合わせて事実確認を行う運用フローが不可欠です。また、技術的な対策として以下の手法を取り入れる企業が増えています。
- プロンプトで「情報源のURLや出典を明記してください」「わからない場合は推測せず、わからないと回答してください」と条件を指定する。ただし、AIが示した出典や根拠そのものが誤っていることもあるため、必ず元の資料で確認する
- 社内マニュアルや信頼できる外部データベースを検索させ、その結果のみを根拠として回答を生成させる技術「RAG(検索拡張生成)」を導入する
- 数値の計算や厳密なデータ照合は従来のシステムやプログラムに任せ、生成AIは文章の要約や翻訳など、事実確認が容易な業務に限定して使用する
著作権や商用利用に関するルール確認
生成AIが作成した画像、文章、プログラムコードなどを自社のWebサイトや広告、製品に利用する場合、他者の著作権を侵害しないよう注意が必要です。文化審議会著作権分科会法制度小委員会が2024年3月に取りまとめ、文化庁が公表している「AIと著作権に関する考え方について」では、AI生成物が著作権侵害となるかどうかの判断基準として、既存の著作物との「類似性(表現が似ているか)」と「依拠性(既存の著作物をもとに作られたか)」の2点が挙げられています。
著作権の整理では、「AIの開発・学習段階」と「生成・利用段階」を分けて考えます。日本の著作権法第30条の4により、学習段階では、著作物に表現された思想や感情の享受を目的としない利用であれば、原則として権利者の許諾なく利用できるとされています(ただし例外あり)。一方、生成物を公開・販売する利用段階では、この規定は適用されず、通常の著作権法の考え方で類似性と依拠性が判断されます。
依拠性については、利用者が既存の著作物を知らなかった場合でも、AIの学習データにその著作物が含まれていれば認められ得るとする見解が、文化庁の整理として紹介されています(該当箇所は原文での確認をおすすめします)。「知らなかった」だけでは安全とは言えないため、公開前の類似性チェックが重要です。
たとえば、画像生成AIに対して特定の作家名や既存のキャラクター名を含むプロンプトを入力したり、特定のクリエイターの作品ばかりを集めて追加学習(ファインチューニング)させたりして酷似した画像を出力・公開した場合、著作権侵害に問われる可能性が高まります。また、法的な問題だけでなく、特定の作風に酷似した生成物を商用利用することで、SNS等で批判が集まり企業のレピュテーション(評判)が低下するリスクも考慮しなければなりません。
さらに、利用する生成AIサービス自体の規約確認も必須です。サービスや契約プラン(無料版・有料版)によって、生成物の商用利用の可否や権利の帰属先が異なります。実務で生成物を外部に公開・販売する際は、以下の項目を事前にチェックしてください。
- 利用する生成AIサービスの利用規約で、商用利用が明確に許可されているか
- 生成過程において、特定の既存著作物や固有名詞に依存したプロンプトを入力していないか
- 出力された画像や文章が、他社の商標や既存のコンテンツと酷似していないか(画像検索やコピペチェックツール等での確認)
- 権利侵害の申し立てがあった場合の補償の有無と条件を、契約内容で確認したか(法人向けプランで補償を設けているサービスもあるが、対象や条件は各社で異なる)
機密情報や個人情報の漏洩リスクへの備え
生成AIサービスの中には、ユーザーが入力したプロンプトやアップロードしたファイルが、AIの精度向上のための機械学習に利用されることがあります。利用されるかどうかは、サービスやプラン、設定によって異なります。そのため、社外秘の企画書、未公開の決算情報、顧客の氏名や連絡先、自社の独自プログラムのソースコードなどをそのまま入力すると、意図せず学習に使われるおそれがあります。
個人情報保護委員会は、2023年6月2日の「生成AIサービスの利用に関する注意喚起等について」で、個人情報取扱事業者があらかじめ本人の同意を得ることなく個人データを含むプロンプトを入力し、それが応答の出力以外の目的(機械学習など)で取り扱われる場合、個人情報保護法に違反する可能性があると示しています。そのうえで、プロンプトを入力する際には、サービス提供事業者が当該個人データを機械学習に利用しないことなどを十分に確認するよう求めています。
企業が安全に生成AIを活用するためには、入力データが学習に利用されない法人向けプランやAPI経由の専用環境を検討することが基本です。たとえば、OpenAIのヘルプによると、ChatGPT Business(旧ChatGPT Team)では、ビジネスデータはデフォルトでトレーニングから除外されます。他のサービスやプランの扱いは、各社の規約でご確認ください。
システム面の整備と並行して、従業員の誤操作を防ぐための社内ガイドラインを策定し、以下の手順でセキュリティ対策を徹底することが重要です。
- 会社として業務利用を許可する生成AIツールと契約プランを限定し、個人の無料アカウントの業務利用(シャドーIT)を禁止する
- ツール側の管理画面で「オプトアウト(入力データをAIの学習に使用させない設定)」を有効にする
- プロンプトに入力してはいけない情報(顧客の個人情報、取引先名、未発表の製品情報、認証パスワードなど)を具体例とともに全社員へ周知する
- 議事録の要約などでテキストを入力する際は、固有名詞を「A社」「担当者B」といった仮名に置き換える(マスキング処理を行う)ルールを徹底する
よくある質問(FAQ)
生成AIはなぜ急に注目されるようになったのですか?
生成AIが急速に普及した主な要因は、基盤となる技術革新と、専門知識を持たない一般ユーザーでも直感的に操作できるサービスが登場したことです。2017年にGoogleの研究者らが発表した深層学習モデル「Transformer(トランスフォーマー)」により、AIが文脈を把握して自然言語を処理する精度が飛躍的に向上しました。この技術を応用して大規模言語モデル(LLM)が開発され、2022年11月にOpenAI社が対話型AI「ChatGPT」を公開したことで世界的な注目を集めました。
従来のAIシステムは、導入や運用にプログラミングなどの専門スキルや高額な開発コストを要するものが大半でした。これに対し、ChatGPTをはじめとする生成AIは、普段使っている言葉(自然言語)で指示(プロンプト)を入力するだけで高精度な回答やコンテンツを得られるため、ビジネスから日常の調べ物まで利用層が一気に拡大しました。
無料で使えるおすすめの生成AIはありますか?
多くの生成AIサービスは、基本機能を試せる無料プランを提供しています。用途に合わせて以下のサービスから使い始めるのが効果的です。
| サービス名 | 主な生成対象 | 無料プランでできること・特徴 |
|---|---|---|
| ChatGPT(OpenAI) | テキスト・画像・音声 | 文章作成、要約、翻訳、アイデア出しのほか、Web検索、データ分析、画像作成などに対応しています(機能ごとに別枠の利用上限があります)。 |
| Claude(Anthropic) | テキスト・コード | 長文の読解や文章作成、プログラミングコードの生成・修正に使われています。Web検索にも対応しています。 |
| Gemini(Google) | テキスト・画像 | Googleアカウントがあれば利用でき、Google検索と連動した情報取得やWorkspaceアプリとの連携が特徴です。無料枠の範囲は変わるため公式で確認してください。 |
| Microsoft Copilot | テキスト・画像 | ブラウザのEdgeやWindows環境から呼び出せ、Designerの画像生成(Image Creator)にも対応しています。無料で使える範囲は時期や環境で変わります。 |
| Adobe Firefly | 画像 | Adobeは、Adobe Stockのライセンス画像などを学習に使っていると説明しています。無料枠の範囲は公式で確認してください。 |
無料プランでは「利用できる回数」や「選択できる最新モデル」に制限が設けられている場合があります。まずは無料で操作感を確かめ、業務での利用頻度が高まった段階で有料プランへの移行を検討すると無駄がありません。
生成AIの普及によって人間の仕事は奪われますか?
生成AIの普及によってすべての仕事がなくなるわけではなく、業務の進め方や人間に求められる役割が変化すると考えられています。定型的なデータ入力、議事録の要約、一次的な翻訳やプログラミングコードの記述といった作業はAIによる自動化が進む一方、AIが出力した内容の最終的な真偽確認、倫理的な判断、複雑な利害関係の調整、ゼロから課題を設定する業務には人間の介入が不可欠です。
国際労働機関(ILO)が2023年8月に公表したワーキングペーパー「Generative AI and Jobs」でも、ほとんどの職種や産業は部分的にしか自動化の影響を受けず、生成AIは職を丸ごと置き換えるよりも、業務の一部を補完する可能性が高いと分析されています。ただし、これは2023年時点の分析で、事務職の業務は影響を受けやすいとも指摘されています。AIに任せられる作業は任せ、人間は企画の立案や対人コミュニケーションなど、付加価値の高い業務へ時間を割く働き方へのシフトが進むと考えられます。
スマートフォンからでも生成AIは利用できますか?
主要な生成AIサービスはスマートフォンに対応しており、パソコンと同じアカウントで履歴を同期しながら利用できるものが多くあります。スマートフォンから利用する方法は主に以下の3つです。
- 公式アプリ:App Store(iOS)やGoogle Play(Android)から、ChatGPT、Claude、Gemini、Microsoft Copilotなどの専用アプリをダウンロードして利用します。スマートフォンのマイク機能を使った音声対話や、カメラで撮影した写真の読み取りに対応するものもあります。
- Webブラウザ:SafariやChromeなどのブラウザから各サービスの公式サイトへアクセスしてログインします。アプリをインストールせずにパソコン版に近い機能を使えます。
- SNSやOSの標準機能:LINEの公式アカウントとして提供されているAIチャットボットや、iPhoneの「Apple Intelligence」、Androidに搭載されている「Gemini」など、端末や既存アプリに組み込まれた機能を呼び出すことも可能です。
なお、スマートフォンアプリストアには公式サービスと名称やアイコンが酷似した非公式アプリも存在するため、ダウンロード時は提供元(デベロッパー名)が「OpenAI」「Google LLC」「Anthropic」などの公式企業であるかを必ず確認してください。
社内で生成AIを導入する際、最初に何をすべきですか?
企業や組織で生成AIを導入する際は、いきなり全社へツールを配布するのではなく、安全かつ効果的に活用するための土台作りから始める必要があります。初期段階では以下の手順を順番に進めてください。
- 解決したい業務課題の特定:「議事録作成の時間を半減させる」「カスタマーサポートの一次回答文を作成する」など、どの部署のどの業務に生成AIを適用するかを明確にします。
- 利用ガイドラインの策定:入力してはいけない情報(個人情報や未公開の財務データなど)の定義や、生成物のファクトチェックおよび著作権確認のルールを明文化します。
- セキュリティ要件を満たすツールの選定:入力データがAIの学習に再利用されない設定(オプトアウト)が可能か、アクセス権限の管理ができるかを確認し、法人向けプラン(ChatGPT Business/Enterpriseや法人向けMicrosoft Copilotなど)を選定します。
- 少人数でのスモールスタート(試験導入):特定の部署やプロジェクトチームに限定して試験的に導入し、業務削減効果の測定や有効なプロンプト(指示文)のテンプレート化を行います。
- 社内研修と全社展開:試験導入で得られた成功事例や注意点を社内に共有し、勉強会を実施した上で利用範囲を段階的に広げます。
社内ルールの策定にあたっては、経済産業省と総務省が策定した「AI事業者ガイドライン」や、一般社団法人日本ディープラーニング協会(JDLA)が公開している「生成AIの利用ガイドライン」のひな形を参考にすると、法的な観点やセキュリティ上の抜け漏れを防ぎやすくなります。AI事業者ガイドラインは2026年3月31日に第1.2版が公表されており、AIエージェントやフィジカルAIに関する整理が加わっています。AIが自律的にタスクを実行する場合は、権限の設定や人間による確認(Human-in-the-loop)も、ルールに含めておくと安心です。なお、このガイドライン自体に法的な拘束力や罰則はありませんが、個人情報保護法や著作権法などの既存の法律は、AIを利用する場合にもそのまま適用されます。
まとめ
従来のAIと生成AIの違いについて、本記事の要点を整理します。
- 従来のAIは学習データから正解を識別・予測し、生成AIは新しいテキストや画像などを創り出す
- ビジネスでは、従来のAIによる需要予測と、生成AIによる文章作成などを目的に応じて使い分ける
- 生成AIの利用時は、事実確認(ハルシネーション対策)や著作権、情報漏洩の防止ルールを徹底する
まずはChatGPTなどの無料ツールに日常業務の質問を入力し、生成AIの利便性を体験してみましょう。