この記事で分かること
- Azure AI Searchの役割とAzure OpenAI Serviceとの連携方法
- ハイブリッド検索とセマンティックランカーが検索精度を高める仕組み
- AWS・Google Cloudなど他社サービスとの選定基準(Kendraは新規受付終了、Vertex AI Searchは名称変更)
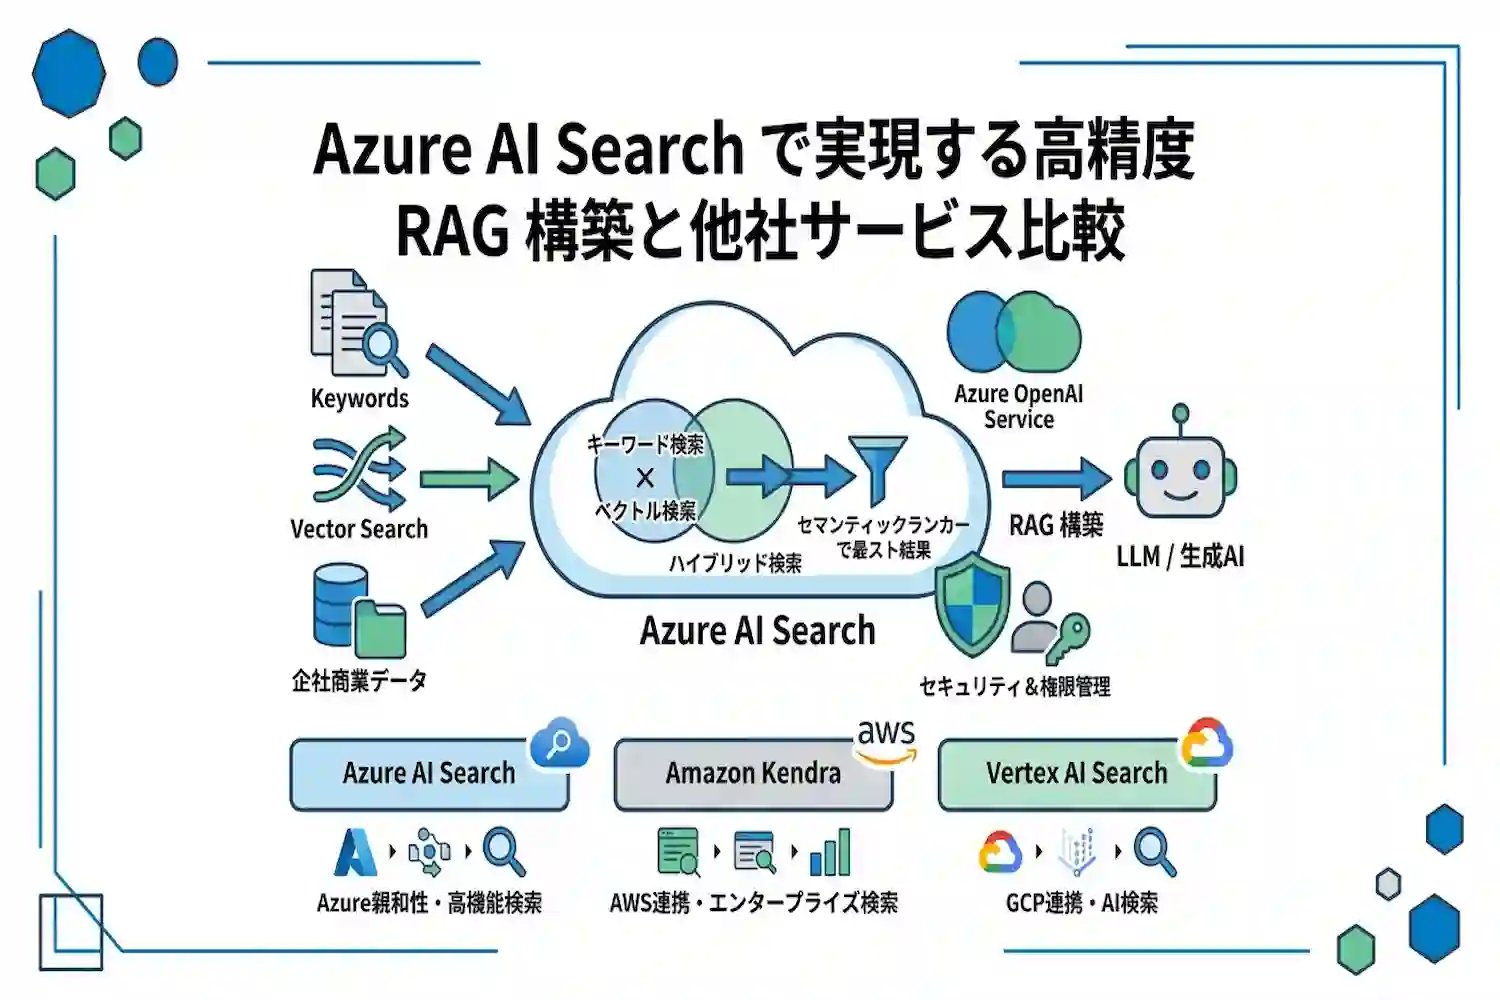
Azure AI Searchは、社内データを活用したRAG(検索拡張生成)システムの構築に使えるクラウド検索サービスです。キーワード検索とベクトル検索を組み合わせたハイブリッド検索により、専門用語の完全一致と文脈理解を両立できます。また、Microsoft Entra IDによる認証や、多様なデータソースからの自動インデクシング(インデクサー)機能を備えています。Azure OpenAI Serviceなどと連携する場合の有力な選択肢ですが、既存のクラウド環境や用途によっては他社製品が適するケースもあるため、それぞれの機能差や料金体系を把握して選定することが重要です。
Azure AI Searchとは?旧Cognitive Searchからの進化と概要
Azure AI Searchは、Microsoftがクラウドプラットフォーム「Microsoft Azure」上で提供する、エンタープライズ向けの検索サービス(Search as a Service)です。開発者はサーバーや検索エンジンのインフラを一から構築・管理することなく、Webサイトや業務アプリケーション、社内ポータルなどに高度な検索機能を組み込むことができます。
このサービスは、技術トレンドや役割の拡大に伴い、以下のように名称と機能を進化させてきました。
| 時期 | サービス名称 | 主な特徴と進化の背景 |
|---|---|---|
| 2015年3月〜 | Azure Search | 最初の名称(公式の更新履歴より)。フルマネージドの検索サービスとして提供。 |
| 2019年10月〜 | Azure Cognitive Search | 公式の更新履歴では、認知スキルやAI処理の利用拡大(任意利用)を反映した改称とされています。OCRや固有表現抽出などのスキルで、非構造化データから検索可能なテキストを抽出できます。 |
| 2023年11月〜 | Azure AI Search | 公式の更新履歴では、Foundry Toolsおよび顧客の期待に合わせた改称とされています。ベクトル検索・ハイブリッド検索の一般提供の時期は今回確認していません。同時に「セマンティック検索」は「セマンティックランカー」に改称されました。 |
公式の更新履歴は、名称変更を「Foundry Toolsおよび顧客の期待に合わせたもの」と説明しています。生成AI向けの機能(ベクトル検索、ハイブリッド検索、セマンティックランカー、エージェント型検索など)が拡充されてきたことは、同じ更新履歴から確認できます。
RAG(検索拡張生成)における重要な役割
ChatGPTをはじめとする大規模言語モデル(LLM)を企業内で業務活用する際、標準のモデルのままでは「社内固有の非公開データに基づいた回答ができない」「事実とは異なる情報を生成する(ハルシネーション)」といった課題が生じます。これらを解決するアーキテクチャとして主流となっているのが、RAG(Retrieval-Augmented Generation:検索拡張生成)です。
RAGは、LLMが回答を生成する前に外部の信頼できるデータベースから関連情報を検索し、その検索結果をプロンプト(指示文)の根拠データとしてLLMに与えて回答を作成させる手法です。Azure AI Searchは、このRAGの仕組みにおいて「情報検索(Retrieval)」のプロセスを一手に担うナレッジベースとして機能します。
具体的に、RAGシステム内では以下の手順で処理が実行されます。
- ユーザーがチャット画面などから質問を入力する
- アプリケーションが質問内容をAzure AI Searchへ送信し、事前に構築された検索インデックスから関連性の高い社内ドキュメントの抜粋を検索・取得する
- 取得した社内データの抜粋とユーザーの質問を組み合わせ、LLMへ送信して最終的な回答を生成する
このプロセスにおいて、LLMが正確な回答を出力できるかどうかは、前段の検索システムが「いかに質問の意図に合致した社内データを漏れなく抽出できるか」に依存します。Azure AI Searchが検索結果として返す情報の精度が、生成AIの回答品質を直接左右するため、RAGアーキテクチャの中核コンポーネントとして位置づけられています。
Azure OpenAI Serviceとのシームレスな連携
RAGシステムを構築する際、LLMの実行環境である「Azure OpenAI Service」と検索基盤である「Azure AI Search」は、同じAzureエコシステム内のサービスとして標準で連携機能が組み込まれています。
通常、独自データを用いたAIチャットシステムを開発する場合、ドキュメントの分割(チャンキング)、テキストの数値化(ベクトル化/Embedding)、検索クエリの実装、LLMへのプロンプト組み立てといった処理を個別にコーディングして繋ぎ合わせる必要があります。しかし、Azure AI SearchとAzure OpenAI Serviceを組み合わせることで、これらの工程の多くを自動化・簡略化できます。
連携によって開発・運用コストを削減できる具体的な機能は以下の通りです。
- 旧Azure AI Studio(現在はMicrosoft Foundry)などの画面上から、自社のデータソースとAzure AI Searchのインデックスを指定して、コードを書かずにチャットボットの検証環境を構築できるとされてきました(「On Your Data」機能。現在の名称・提供状況は今回確認していません)
- Azure AI Searchの「統合ベクトル化(Integrated Vectorization)」機能により、インデクサーによる取り込み時のベクトル化と、検索時の質問文のベクトル化(ベクトライザー)を、検索サービス側のパイプラインで処理できる(チャンク分割にはText Splitスキルなどを使い、埋め込みモデルはAzure OpenAIのtext-embedding-3系などに対応)
- サービス間の接続にプライベートエンドポイント(Azure Private Link)を利用でき、Microsoft Entra IDによる認証を構成できる(公式のセキュリティ概要ではPrivate LinkとEntra IDによる認証に言及。マネージドIDの詳細は今回未確認)
ナレッジベースとエージェント型検索(2026年の動向)
Azure AI Searchの公式更新履歴によると、2025年11月にエージェント型検索の「knowledge agents」が「knowledge bases(ナレッジベース)」に改称され、2026年4月にナレッジベースと、検索インデックス・Blob・OneLake・Webの各ナレッジソースが一般提供(REST API 2026-04-01)になりました。クエリ計画や回答生成などは引き続きプレビューです。また、2025年11月には、Foundry Agent ServiceのエージェントがAzure AI Searchのナレッジベースを呼び出せる「Foundry IQ」がプレビューで追加されています。
このように、モデルと検索エンジンの接続部分を自前で開発・保守する手間が省けるため、企業はインフラの繋ぎ込みではなく、業務要件に合わせたプロンプトの調整やユーザーインターフェースの改善にリソースを集中させることができます。
なぜAzure AI Searchが多くの企業に選ばれるのか
企業が社内検索システムや生成AI基盤を構築する際、検索精度の高さだけでなく、既存の業務システムと安全かつ効率的に統合できるかどうかが導入の成否を分けます。Azure AI Searchは、Microsoft Azureのエコシステムと深く統合されており、セキュリティ対策、データ連携の自動化、非構造化データの処理という3つの運用課題を解決する機能を備えています。
エンタープライズレベルの堅牢なセキュリティと権限管理
社内データを検索対象とするシステムでは、ネットワークの保護と、ユーザーの役職や所属部署に応じた閲覧権限の制御が不可欠です。Azure AI Searchは、Azureが提供する標準のセキュリティ機能と連携し、通信経路からデータアクセスまでの多層防御を実現します。
ネットワーク層では、Azure Private Linkによるプライベートエンドポイント接続を利用できます。公式のセキュリティ概要では、サービス間の認証・認可はMicrosoft Entra IDを通じて行われ、Azure Private Linkを使うプライベートエンドポイント接続に対応すると説明されています。マネージドIDによるAPIキーレス運用の詳細は、今回公式で確認していません。
データの保護においては、公式のセキュリティ概要によると、保存データはMicrosoft管理キーによる256ビットAESで自動的に暗号化され、顧客管理キー(CMK)を構成すると、サービス管理の暗号化の上に第2の暗号化層が追加されます。ドキュメント単位の権限制御については、公式の更新履歴に、Blob・OneLakeのナレッジソースでのドキュメントレベル権限(ingestionPermissionOptions)がプレビューとして記載されています。フィルターによるクエリ時のセキュリティトリミングの実装手順は、今回公式で確認していませんので、導入前に公式ドキュメントで確認してください。
| セキュリティ項目 | 主な機能・仕組み | 企業システムにおける導入効果 |
|---|---|---|
| ネットワーク分離 | Azure Private Link(プライベートエンドポイント)など(仮想ネットワーク統合・IPファイアウォールの詳細は今回未確認) | パブリックインターネットからのアクセスを遮断し、閉域網内で通信を完結させる |
| 認証・認可 | Microsoft Entra IDによる認証(RBAC・マネージドIDは今回未確認) | APIキーの管理負荷をなくし、最小権限の原則に基づいた運用を実現する |
| データ保護 | 保存データの暗号化(Microsoft管理キー)、顧客管理キー(CMK)による第2の暗号化層 | 金融や医療など厳格な業界基準が求めるデータ暗号化要件を満たす |
| ドキュメントレベルの権限制御 | フィルター等による制限(ドキュメントレベル権限の一部機能はプレビュー) | 閲覧権限を持つユーザーのみに該当ドキュメントを検索結果として返す |
多様なデータソースからのインデクサー自動取り込み
企業内のデータは、ファイルサーバー、データベース、クラウドストレージなど複数の場所に分散しています。通常、これらを検索エンジンに取り込むには、データの抽出・変換・書き出しを行うETL処理プログラムを個別に開発しなければなりません。Azure AI Searchでは、「インデクサー」と呼ばれる機能を使うことで、データ取り込みのパイプラインをコードレスまたは最小限の実装で構築できます。
公式ページによると、インデクサーはオンデマンドまたは定期スケジュール(最短5分間隔)で実行でき、初回は全データを読み取り、以降は変更されたデータのみを取得できる場合が多いとされています(Blobは変更検出が自動で、Azure SQLやCosmos DBなどは有効化が必要)。また、データを直接送信するプッシュAPIも用意されているため、定常的な同期はインデクサーで行い、即時性が求められる更新のみAPI経由で行うといった柔軟な運用が可能です。代表的な対応データソースは以下の通りです。
- Azure Blob StorageおよびAzure Data Lake Storage Gen2(PDF、Word、Excel、PowerPoint、HTML、JSON、CSVなどの各種ファイル)
- Azure SQL Database、Azure SQL Managed Instance、SQL Server on Azure Virtual Machines
- Azure Cosmos DB(MongoDB API、Gremlin APIは公式ページでプレビュー表記。Cassandra APIは非対応)
- Azure Table Storage、Microsoft OneLake、Azure Files(プレビュー)、Azure MySQL(プレビュー)
- SharePoint in Microsoft 365(プレビュー)
たとえば、Azure Blob Storageに格納された大量の業務マニュアル(PDFやWordファイル)を対象とする場合、インデクサーを設定するだけで、本文のテキストと作成日・作成者などのメタデータが自動的に抽出され、検索可能な状態に変換されます。Blobでは変更検出が自動のため、元ファイルが更新された際も変更分のみが再処理される場合が多く、システム全体の負荷と通信コストを抑えられます。
AIエンリッチメントによる非構造化データの構造化
スキャンされた紙の契約書(画像PDF)や手書きのメモ、設計図面、長文の報告書といった非構造化データは、そのままではテキストとして検索したり、属性ごとに絞り込んだりすることが困難です。Azure AI Searchは、インデクサーがデータを取り込む過程にFoundry Tools(旧Azure AIサービス、前身はCognitive Services)の機能を組み込む「AIエンリッチメント(スキルセット)」を提供しています。
スキルセットを定義すると、データソースから抽出した生データに対し、複数のAI処理を順番に適用して新しい情報を付与し、構造化された検索インデックスを生成できます。組み込みスキルとして提供されている主な処理は以下の通りです。
- 光学式文字認識(OCR)スキルによる、画像やスキャン済みPDF内の印字・手書き文字のテキスト化
- 固有表現抽出(NER)やキーフレーズ抽出スキルによる、人名・組織名・場所・重要語句の自動タグ付け
- テキスト翻訳スキルによる、多言語で書かれた海外拠点ドキュメントの日本語への統一
- テキスト分割およびAzure OpenAI Embeddingスキルによる、長文ドキュメントのチャンク分割とベクトル化データの自動生成
また、標準の組み込みスキルだけでは対応できない社内固有の業務ロジックや独自モデルがある場合は、Azure FunctionsやAzure Machine Learningと連携する「カスタムスキル」を追加できます。これにより、画像内の文字読み取りから社内用語の正規化、ベクトル化までを単一のパイプラインで自動化でき、データ前処理にかかる開発工数と運用コストを大幅に削減します。
検索精度を劇的に高めるハイブリッド検索の仕組み
Azure AI Searchが企業の検索基盤として高い評価を得ている最大の理由は、複数の検索手法を単一のクエリで同時に実行し、それぞれの弱点を補完し合うアーキテクチャにあります。従来の文字列一致に基づく検索と、AIモデルを用いた意味理解に基づく検索がどのように機能し、統合されるのかを具体的に解説します。
キーワード検索(全文検索)のメリットと限界
キーワード検索(全文検索)は、入力された検索語句とドキュメント内のテキストがどれだけ正確に一致するかを評価する手法です。Azure AI Searchでは、テキストを単語(トークン)単位に分割するアナライザーと転置インデックスを用い、統計的なランキングアルゴリズムである「BM25」によって関連度スコアを算出します。
BM25は、検索語句がドキュメント内に出現する頻度(TF)と、その語句が全ドキュメントの中でどれだけ珍しいか(IDF)を計算し、ドキュメントの長さによる偏りを補正して順位を決定します。この仕組みにより、以下のような特定の文字列を探し出す場面で高い精度を発揮します。
- 製品型番や部品番号、エラーコード(例:「Error 0x80070005」)の完全一致検索
- 社内固有のプロジェクト名や人名、専門用語の抽出
- 契約書や規約における特定条文・条項のピンポイントな参照
一方で、キーワード検索には表記ゆれや類義語に対応できず、文脈の意図を汲み取れないという構造的な限界が存在します。たとえば、検索窓に「PCがネットに繋がらない」と入力した場合、マニュアル側の表記が「コンピュータのネットワーク接続障害」となっていれば、文字面が一致しないため検索結果から漏れてしまいます。類義語辞書(シノニムマップ)を手動で登録して対応する方法もありますが、日々増え続ける社内データのあらゆる言い換えを網羅し、メンテナンスし続けることは運用上の大きな負担となります。
ベクトル検索が実現する意味ベースの情報取得
キーワード検索の課題を解決するのがベクトル検索です。ベクトル検索では、テキストや画像などのデータを埋め込みモデル(Embedding Model)に通すことで、数百から数千次元の数値の配列(ベクトル)に変換してインデックスに格納します。検索時も同様に、ユーザーが入力した質問文をベクトル化し、データベース内のベクトル空間上で距離や角度が近い(コサイン類似度などが高い)データを探索します。
Azure AI Searchでは、高速な近似最近傍探索(ANN)アルゴリズムである「HNSW(Hierarchical Navigable Small World)」や、網羅的な「網羅的KNN(k近傍法)」をサポートしています。意味が似ている言葉や文章はベクトル空間上の近い位置に配置されるため、単語の完全一致に依存しない検索が可能です。
たとえば、「経費精算の締め日はいつ?」という自然言語の質問に対して、「交通費や交際費の申請は毎月末日までに完了してください」といった、質問文と共通する単語がほとんどないドキュメントであっても、意味的な近さから正確に抽出できます。また、多言語対応の埋め込みモデルを使用すれば、日本語の質問文で英語の技術仕様書を検索するといったクロスリンガル検索も実現します。
しかし、ベクトル検索も万能ではありません。文章全体の意味を抽象的な数値に圧縮する特性上、型番の1文字違いや、初見の固有名詞、厳密な数値条件などを区別することが苦手です。ベクトル検索単体では、「品番A-101」を探しているのに、文脈が似ている「品番A-102」のドキュメントを上位に表示してしまうといった現象が起こり得ます。
両者を融合したハイブリッド検索とRRFアルゴリズム
キーワード検索の「厳密な一致に対する強さ」と、ベクトル検索の「文脈や意味の理解力」を同時に活かす手法がハイブリッド検索です。Azure AI Searchでは、1回の検索リクエストの中で全文検索とベクトル検索を並列で実行し、双方の結果を単一のランキングに統合して返却します。
| 検索手法 | 評価の基準 | 得意なクエリ・用途 | 苦手なクエリ・弱点 |
|---|---|---|---|
| キーワード検索(全文検索) | 単語の出現頻度と希少性(BM25) | 型番、エラーコード、固有名詞、特定用語の完全一致 | 類義語、表記ゆれ、自然言語による長い質問文 |
| ベクトル検索 | 高次元空間における意味の近さ(コサイン類似度など) | 概念的な質問、言い換え表現、多言語間の検索 | 未知の専門用語、記号や数値の厳密な識別 |
| ハイブリッド検索 | 双方の順位を統合した相対評価(RRF) | 固有名詞と自然言語が混在する実務的なあらゆる検索 | 単一手法に比べ計算リソースを多く消費する |
このとき技術的な課題となるのが、スコアの統合方法です。キーワード検索(BM25)とベクトル検索(HNSWまたはeKNN)は評価の仕組みが異なるため、単純に足し算や平均化をすることができません。公式ページによると、Azure AI Searchは両者の結果を「RRF(Reciprocal Rank Fusion:逆順位融合)」で統合し、1つの結果セットとして返します。
RRFは、スコアの絶対値ではなく、各検索手法での順位に着目して統合する手法として知られています(一般的には、順位に基づく値を合算して総合スコアを出します。Azure AI Searchでの計算の詳細は、公式の「Relevance scoring in hybrid search」のページで確認してください)。これにより、両方の手法で上位に入ったドキュメントが高く評価されやすく、片方でしかヒットしなかった重要なドキュメントも拾いやすくなるとされています。
セマンティックランカーによる再ランク付けの仕組み
ハイブリッド検索によって統合された検索結果の精度をさらに高める機能が「セマンティックランカー」(旧称:セマンティック検索。2023年11月に改称)です。公式ページによると、Bingなどで培われた多言語のディープラーニングモデルを応用して、検索結果を再ランキングする機能です。
公式ページによると、検索結果が50件を超えても、セマンティックランキングに進むのは上位50件のみです。Bi-Encoder・Cross-Encoderといったモデル方式の違いは、今回公式で確認していません。
セマンティックランカーが実行されると、検索結果の並び替えだけでなく、以下の処理が同時に行われます。
- ハイブリッド検索などで得られた結果のうち、上位最大50件が再ランキングの対象になる
- モデルが関連度スコア(@search.rerankerScore。4〜0で高いほど関連度が高い)を付与して順位を再編成する
- 質問形式のクエリでは、オプションで「セマンティックアンサー」(質問への直接の回答になる本文中のテキスト)を返す
- 「セマンティックキャプション」として、内容を最もよく表す文やフレーズを本文からそのまま抜き出し、重要な箇所をハイライト表示する(アンサー・キャプションとも、生成AIによる新規の文章作成ではなく、インデックス内の本文そのものです)
Microsoftの公式ドキュメントには、「実データおよびベンチマークデータでのテストにより、セマンティックランカーを組み合わせたハイブリッド検索は検索の関連性に大きなメリットがある」と記載されています(具体的な指標や数値は同ページにはありません)。生成AIに社内データを参照させるシステムでは、プロンプトに渡す情報のノイズを減らす助けになります(ハルシネーションを確実に防ぐものではありません)。
Azure AI Searchと他社検索サービスの徹底比較
エンタープライズ検索やRAG(検索拡張生成)の基盤を選定する際、既存システムのクラウド環境や開発チームの技術スタック、求めるカスタマイズの粒度によって最適なサービスは異なります。主要クラウドベンダーであるAWSやGoogle Cloudが提供する検索サービス、およびオープンソースベースの検索エンジンや特化型ベクトルデータベースとAzure AI Searchを比較し、それぞれの機能差と選定基準を解説します。
| サービス名 | 提供形態・特徴 | 検索アプローチ | 主な連携エコシステム | 適したユースケース |
|---|---|---|---|---|
| Azure AI Search | PaaS型マネージド検索サービス | キーワード、ベクトル、ハイブリッド+セマンティックランカー | Microsoft Azure(Azure OpenAI Service、Entra ID等) | 細かな精度チューニングが求められるRAG基盤、Microsoft製品群との連携システム |
| Amazon Kendra | マネージド型エンタープライズ検索。2026年6月30日からメンテナンスモード、7月30日から新規顧客の受付終了(AWS公式) | 機械学習ベースの自然言語検索、キーワード | AWS(Amazon Bedrock、Amazon S3等) | 既存利用者の社内ドキュメント検索(新規構築にはAmazon Bedrock Knowledge Basesへの移行が推奨されています) |
| Amazon OpenSearch Service | OpenSearchのマネージドサービス | キーワード、ベクトル(k-NN)、ハイブリッド | AWS全般、オープンソースツール群 | ログ分析と検索基盤の統合、クラスタ構成やアルゴリズムの細かな制御 |
| Agent Search(旧Vertex AI Search) | 生成AI統合型マネージド検索プラットフォーム | Google検索技術ベースのセマンティック検索、ベクトル、キーワード | Google Cloud(Gemini、BigQuery、Google Workspace等) | ECサイトの商品検索、最小限の設定で構築するエージェント開発や社内検索 |
| Elasticsearch | オープンソースベースの検索・分析エンジン | キーワード(BM25)、ベクトル、ハイブリッド | マルチクラウド(AWS、Azure、GCP)、オンプレミス | 特定クラウドに依存しないシステム構築、大規模なオブザーバビリティやセキュリティ分析の併用 |
| Pinecone | フルマネージド型ベクトルデータベース | 高次元ベクトル検索(疎密ベクトルによるハイブリッド対応) | マルチクラウド、LangChainやLlamaIndex等のフレームワーク | 数億〜数十億規模のベクトルデータを低遅延で処理するAIアプリケーション |
Amazon KendraやOpenSearchとの機能と特徴の比較
AWS環境で検索基盤やRAGを構築する場合、比較対象となるのが「Amazon Kendra」と「Amazon OpenSearch Service」です。AWSではこれら2つのサービスに役割が分かれているのに対し、Azure AI Searchは1つのサービスでドキュメント取り込みから高度な検索アルゴリズムの調整までをカバーするアーキテクチャを採っています。
Amazon Kendraは、社内文書やFAQの検索に特化したマネージドサービスです。ただし、AWSの公式案内によると、Kendraは2026年6月30日からメンテナンスモードに入り、2026年7月30日以降は新規顧客を受け付けていません。既存の利用者には引き続きバグ修正とセキュリティ更新が提供されますが、新機能の開発は行われず、AWSは新規構築にAmazon Bedrock Knowledge Basesの利用を推奨しています。以下の特徴は既存利用者向けの参考情報として、従来の記述を残します。SharePointやSalesforce、Amazon S3など多数のデータソースに対応するコネクタを備え、自然言語での質問に対して回答を抽出する点や、チャンキングやベクトル化、スコアリングの細かな制御には向かない点が特徴とされてきました(今回の公式確認は上記の提供状況のみです)。
一方、Amazon OpenSearch ServiceはオープンソースのOpenSearchをベースとしており、インデックス構造の設計、トークナイザー(形態素解析器)の選択、k-NN(k近傍法)を用いたベクトル検索のパラメータ調整など、システム要件に応じた柔軟なカスタマイズが可能です。ただし、クラスタのサイジングやシャード設計といったインフラに近い管理知識が求められます(Serverlessオプションを除く)。
Azure AI Searchは、インデクサーによる自動データ取り込みというKendraに近い利便性を持ちながら、OpenSearchのようにインデックスのスキーマ定義やスコアリングプロファイル、アナライザーの選択を API 経由で細かく制御できる点が特徴です。AWS上でデータが集約されている場合は、Kendraは新規受付を終了しているため、AWSが推奨するAmazon Bedrock Knowledge BasesやAmazon OpenSearch Serviceなどが比較対象になります。RAGの回答精度を高めるために検索パイプラインを緻密にチューニングしたい場合は、Azure AI Searchも有力な選択肢です。
Google Cloud Agent Search(旧Vertex AI Search)との違い
Google Cloudが提供する「Vertex AI Search(旧Enterprise Search)」は、Googleが培ってきたWeb検索の技術を企業データ向けに提供するサービスとして紹介されてきました。Googleのリリースノートによると、2026年4月22日に「Vertex AI」から「Gemini Enterprise Agent Platform」への名称整理が行われ、「Vertex AI Search」は「Agent Search」に変更されました。Vertex AI Agent Builderの新名称は、今回確認できていません。以下の機能説明は旧名称時点の記述で、今回公式で再確認していません。
Vertex AI SearchとAzure AI Searchの最大の違いは、導入時の抽象化レベルとチューニングのアプローチにあります。Vertex AI Searchは「Out-of-the-Box(導入してすぐに使える)」の思想が強く、PDFやWebサイト、BigQueryのデータを指定するだけで、データの解析、チャンキング、埋め込み(Embedding)の生成、インデックス作成までがバックグラウンドで自動的に実行されます。さらに、ECサイトやメディアサイト向けに、ユーザーのクリック履歴や購買履歴を学習して検索結果を最適化するレコメンデーション機能が標準で組み込まれています。
対してAzure AI Searchは、検索の構成要素をモジュールとして開発者に開放しています。どの埋め込みモデルを使うか、どのフィールドをベクトル検索の対象とし、どのフィールドをキーワード検索の対象とするかを明示的に設計します。そのため、初期構築の手間はVertex AI Searchの方が少なく済みますが、業界固有の専門用語や社内独自の型番などを正確にヒットさせるためのカスタマイズ性においては、アナライザーやカスタムスキルを柔軟に組み合わせられるAzure AI Searchに優位性があります。また、Google Workspace(GoogleドライブやGmail)のデータを中心に検索する場合はVertex AI Searchがスムーズですが、Microsoft 365やEntra IDを中心とした認証・データ基盤を持つ企業ではAzure AI Searchの方が権限継承を含めた統合が容易です。
ElasticsearchやPineconeなど特化型サービスとの使い分け
クラウドベンダー純正のサービス以外にも、検索エンジンとして実績のある「Elasticsearch(Elastic Cloud)」や、ベクトル検索に特化した「Pinecone」などのサードパーティ製サービスが存在します。これらはマルチクラウド戦略をとる企業や、特定の性能要件を持つシステムで採用されています。
Elasticsearchは、Azure AI Searchと同じくApache Luceneをベースとした検索エンジンです。全文検索の高度なクエリ構文、豊富な日本語形態素解析プラグイン(Kuromojiなど)、そしてベクトル検索やハイブリッド検索の機能を備えています。Azure AI Searchとの決定的な違いは「ポータビリティ(移植性)」と「用途の広さ」です。Azure AI SearchはAzure環境にロックインされますが、ElasticsearchはAWS、Google Cloud、Azure、さらにはオンプレミス環境でも同一のアーキテクチャで稼働します。また、アプリケーションの検索基盤としてだけでなく、システムログの収集・監視(オブザーバビリティ)やSIEM(セキュリティ情報イベント管理)の基盤としても共通のノウハウで運用できます。
Pineconeは、ベクトル検索に特化したフルマネージド型のベクトルデータベースです。公式ドキュメントによると、疎ベクトルと密ベクトルを組み合わせたハイブリッド検索に対応し、1つのインデックスに両方を格納する方式と、別々のインデックスで検索して結果を統合する方式があります。複雑なファセット検索やドキュメントの自動取り込み・OCRといった周辺機能の有無は、今回公式で確認していません。
これら特化型サービスとAzure AI Searchを使い分ける際の判断基準は以下の通りです。
- Azure AI Searchを選ぶべきケース:システムの主軸がAzure上にあり、ドキュメントからのテキスト抽出、チャンク分割、ベクトル化、ハイブリッド検索、セマンティックランカーによる再順位付けまでを単一のマネージドサービス内で完結させたい場合。
- Elasticsearchを選ぶべきケース:将来的なクラウド移行を見据えて特定ベンダーへの依存を避けたい場合や、独自の辞書登録・クエリチューニングを極限まで行いたい場合、またはログ分析基盤と検索基盤を統合したい場合。
- Pineconeを選ぶべきケース:データの前処理やベクトル化のパイプラインは自社で構築済みであり、数億件を超える大規模なベクトルデータに対して、ミリ秒単位の低遅延な類似度検索と柔軟なスケーリングのみをシンプルに求めている場合。
各サービスは検索アルゴリズム自体に共通点も多いものの、データ取り込みの自動化範囲やインフラ管理の要否、既存システムとの認証連携のしやすさに明確な差があります。検索精度だけでなく、開発・運用チームのスキルセットと照らし合わせて選定することが重要です。
よくある質問(FAQ)
Azure AI Searchの料金はどのように計算されますか?
Azure AI Searchの料金は、選択する価格レベル(ティア)と割り当てる検索ユニット(SU)の数によって時間単位で計算されます。検索ユニットとは、データを保持する「パーティション」と、クエリ処理や負荷分散を担う「レプリカ」の2つの要素を掛け合わせたリソースの単位(SU = パーティション数 × レプリカ数)です。
基本料金に加えて、利用するオプション機能に応じた従量課金が発生します。主な課金要素は以下の通りです。
- ベースとなる検索ユニット(SU)の稼働時間に応じた基本料金
- セマンティックランカーの利用料金(公式ページによると、月間の無料枠があり、超過後は従量課金。具体的な無料枠の件数は同ページに記載がなく、2026年4月からエージェント型検索とは課金の同意が分かれています)
- インデクサーでPDFや画像からテキストを抽出する際のドキュメントクラッキングやAIスキル実行コスト
- 公式の更新履歴によると、2026年6月から使った分だけ課金する「Serverless」料金モデルがプレビューで提供され、スケールゼロで最低容量の課金がありません
各価格レベルにおける主な特徴と用途の違いは以下の表の通りです。
| 価格レベル(ティア) | 主な用途 | 特徴・制限事項 |
|---|---|---|
| Free | 機能検証・学習用 | 無料で利用可能ですが、ストレージ容量は50MB、作成できるインデックスは3つまでに制限され、スケールアウトはできません。 |
| Basic | 小規模な本番環境・部門内システム | 小規模なデータセット向けです。2024年4月3日以降に作成したサービスは最大3パーティション・3レプリカ(最大9 SU)、それ以前のサービスは1パーティション・3レプリカです。1パーティションの容量は新しいサービスで15GB(旧サービスは2GB)です。 |
| Standard (S1 / S2 / S3) | 一般的な企業システム・RAG基盤 | 中〜大規模な商用環境向けです。S1からS3へ向かうにつれて1パーティションあたりのストレージ容量が増え(2024年5月17日以降に作成したサービスで、S1が160GB、S2が512GB、S3が1TB)、最大36 SU(最大12パーティション×12レプリカの範囲内)まで拡張できます。 |
| Storage Optimized (L1 / L2) | 大容量データのアーカイブ検索 | クエリ頻度は低いものの、大量データを低コストでインデックス化したい場合に適しています。1パーティションの容量はL1が2TB、L2が4TB(2024年5月17日以降に作成したサービス)です。 |
サービスは作成して稼働している間、検索リクエストの有無にかかわらず時間単位で課金されます。不要なコストを抑えるためには、開発環境ではBasicティアを選択するか、使用しない期間にレプリカやパーティションの数を最小化しておく運用が有効です。最新の単価や詳細な条件については、Azure AI Search の価格ページで確認できます。
日本語のドキュメントでも高い検索精度は出せますか?
Azure AI Searchは日本語特有の言語処理に標準対応しており、高い検索精度を実現できます。日本語は英語のように単語間がスペースで区切られていないため、文章を意味のある単語単位に分割する「形態素解析」の精度が検索品質を左右します。
Azure AI Searchには、日本語向けのアナライザー(解析器)として以下の2種類が搭載されており、用途に応じてフィールドごとに選択できます。
- Microsoft 日本語アナライザー(ja.microsoft):公式ページによると、OfficeやBingで使われるMicrosoft独自の自然言語処理技術を用いたアナライザーです。
- Lucene 日本語アナライザー(ja.lucene):Apache Luceneの言語アナライザーを基にしています(具体的な形態素解析器の名称は、公式ページには記載がありません)。
また、「サーバー」と「サーバ」のような表記ゆれや、業界特有の専門用語・社内略語などに対しては、シノニム(類義語)マップなどを登録することで、検索漏れを防ぎます。さらに、多言語対応の埋め込みモデルを用いたベクトル検索やセマンティックランカーを組み合わせることで、日本語の文脈や言い換え表現も正確に捉えた検索が可能です。
導入にあたって専門的なプログラミングスキルは必要ですか?
基本的な検索インデックスの作成や、生成AIと連携したチャットボットのプロトタイプ構築であれば、専門的なプログラミングスキルがなくても導入可能です。Azureポータルなどの画面上から、GUI(グラフィカルユーザーインターフェース)ベースで設定を完結できるためです。
ノーコードで構築する際は、管理画面の「データのインポート(Import data)」ウィザードを使用します(公式の更新履歴によると、2026年3月に従来の2つのウィザードがこの1つに統合され、キーワード検索、RAG、マルチモーダルRAGに対応しています)。以下は一般的な手順で、画面の表示は更新されている場合があります。
- データソース(Azure Blob StorageやSharePointなど)の接続情報を指定する
- テキストをベクトル化するためのAzure OpenAIの埋め込みモデルを選択する
- ドキュメントのチャンク(分割)サイズやインデクサーの実行スケジュールを設定する
一方で、既存の社内業務システムへの検索画面の組み込みや、複雑なメタデータフィルタリング、独自のアクセス権限ロジックの実装などを行う場合は、C#、Python、Java、JavaScript(TypeScript)などのプログラミングスキルと、REST APIまたはAzure SDKを用いた開発が必要です。
社内データのサイズやドキュメント数に上限はありますか?
格納できるデータの最大サイズやドキュメント数は、選択する価格レベルと割り当てるパーティション数によって決まります。Freeティアでは50MBという厳しい制限がありますが、上位のStandardティアやStorage Optimizedティアを選択し、パーティションを最大12個まで増やすことで、サービス全体の容量が増えます。公式ページに「24TB」という表記はありませんが、パーティション容量×パーティション数で算出すると、2024年5月17日以降に作成したサービスでS1が約1.9TB、S2が約6TB、S3が約12TB、L1が約24TB、L2が約48TBです(古いサービスは容量が小さい場合があります)。
ただし、ストレージ全体の容量以外にも、システム設計時に考慮すべき細かな上限値が存在します。代表的な制限事項は以下の通りです。
| 制限項目 | 主な上限値・仕様 |
|---|---|
| 1サービスあたりの最大インデックス数 | Freeは3個、Basicは15個(2017年12月より前に作成したBasicは5個)、S1は50個、S2は200個、S3は200個です。S3 High Densityモードは1パーティションあたり1,000個(サービス全体で3,000個)、L1・L2は10個です。 |
| 1インデックスあたりの最大フィールド数 | Freeを含む各ティアで最大1,000個です。ただし、2024年4月3日より前に作成したBasicは最大100個です。 |
| インデクサーが読み取れるファイルサイズ | Blobなどのインデクサーで読み取れる1ファイルの上限は、FreeとBasicが16MB、S1が128MB、S2・S3・L1・L2が256MBです。 |
| ベクトルインデックスのサイズ | ベクトルのクォータは、サービスの作成時期(2023年7月以前、2024年4月、2024年5月以降など)によって異なります。詳細は公式の制限ページで確認してください。 |
特にベクトル検索を利用する場合、元のテキストデータよりもベクトルデータ(数値の配列)の方が多くの容量を消費する傾向があります。大量のドキュメントを扱う際は、次元数の圧縮(量子化)機能を活用するか、あらかじめサービスの制限とクォータに関する公式ドキュメントを参照して必要なティアを見積もることが重要です。
リアルタイムでのデータ更新や検索反映は可能ですか?
データの追加や更新をほぼリアルタイム(数秒以内)で検索結果に反映させることは可能ですが、データの連携方法によって反映までのタイムラグが異なります。Azure AI Searchへのデータ登録には、「プル型」と「プッシュ型」の2つのアーキテクチャがあるためです。
それぞれのデータ連携方式における更新反映の仕組みと速度の違いは以下の通りです。
- プル型(インデクサーによる定期取得):データソースの変更を検知して自動で取り込む方式ですが、最短の実行間隔が「5分ごと」に制限されているため、完全なリアルタイム反映にはなりません。
- プッシュ型(APIによる直接送信):データが発生・更新されたタイミングで、アプリケーション側からREST APIやSDK(Index Documents API)を呼び出して直接データを流し込む方式です。公式ページは、インデクサーの最短5分より頻繁な更新にはプッシュ方式が必要としています(反映までの具体的な秒数は今回未確認)。
ECサイトの在庫状況や、社内掲示板の緊急のお知らせなど、更新直後に検索結果へ反映させる必要があるシステムでは、プッシュ型のAPI連携を採用します。たとえば、データベースへの書き込みをトリガーにしてAzure Functions(サーバーレス関数)を起動し、そこからAzure AI Searchへ差分データをプッシュする構成を組むことで、運用の自動化とリアルタイム性を両立できます。
まとめ
本記事で解説したAzure AI Searchの要点は以下の通りです。
- Azure OpenAI Serviceと連携し、社内データを活用するRAGの検索基盤を構築できる
- キーワード検索、ベクトル検索、セマンティックランカーを組み合わせたハイブリッド検索により、文脈と用語の双方を捉えて検索精度を高められる
- Microsoft Entra IDによる認証、暗号化、非構造化データの自動処理(インデクサーとスキルセット)により、企業のセキュリティ要件に沿った運用がしやすくなる
既存のクラウド環境や対象データの形式に合わせて他社サービスと比較し、まずは無料枠や小規模な検証環境から自社データでの検索精度を実際に確認してみましょう。