この記事で分かること
- OCR、画像分析、顔認識などの主要機能と、提供終了の予定
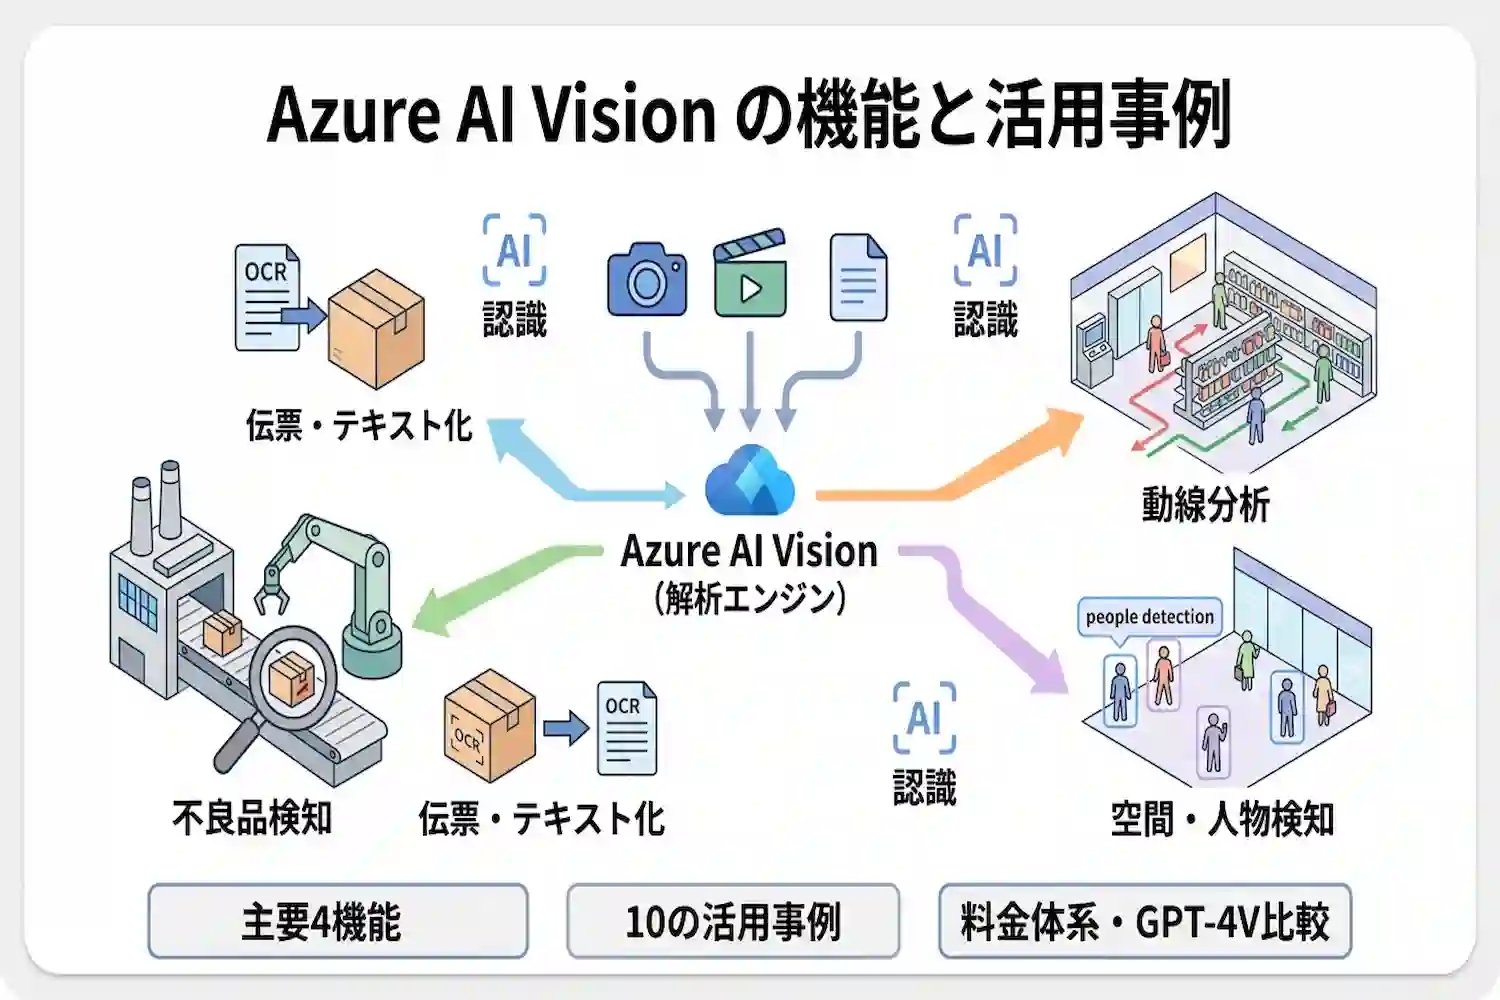
- 製造業の不良品検知や小売業の動線分析など10の活用シナリオ(想定例)
- 無料枠の範囲や従量課金制の料金体系、GPT系モデルとの違い
Azure AI Visionは、画像から文字・物体・人物の顔などを検出するMicrosoftのAIサービスです(現在のMicrosoft Learnでの表記は「Azure Vision in Foundry Tools」)。企業の担当者はAPIやノーコードツール「Vision Studio」を使い、伝票のテキスト化などを試せます。ただし、後述の通り提供終了となった機能や提供終了が予定されている機能があるため、新規導入では注意が必要です。
【重要】Azure AI Visionの提供終了の予定と現状
導入を検討する前に、公式ドキュメントで確認できた提供状況を整理します。
- Image Analysis API(v3.2・v4.0)は、2028年9月25日に提供終了の予定です。クラウドAPI、接続コンテナー、切断コンテナーのすべてが対象で、提供終了後は呼び出しが失敗します。公式は2026年9月25日までに移行計画を立てるよう案内しており、この日付は既に過ぎています。
- 公式の移行ガイドが挙げる代替手段は、OCRはDocument Intelligence、顔関連はFace API、画像埋め込みはCohere EmbedやSigLIP、その他の画像分析はFoundryのGPT系モデルやAzure Content Understandingです。
- 現行の公式概要では、Face、Image Analysis(legacy)、OCR(legacy)の3つが列挙されています。レガシーのOCR API(v3.2)は、公式で「使用を推奨しない」とされています。
- Microsoftのリタイア告知(Message Centerのアーカイブ)によれば、Image Analysis 4.0のカスタム画像分類・カスタム物体検出などのプレビューAPIは2025年1月10日に、空間分析(Spatial Analysis)のEdgeコンテナーは2025年3月30日に提供が終了しました。背景削除機能は、公式の概要ページで2025年3月31日に提供終了と記載されています。
- 別サービスのAzure Custom Visionも、2028年9月25日までがフルサポート期間とされています。
Azure AI Visionとは?画像解析で実現できること
Azure AI Visionは、Microsoftがクラウドプラットフォーム「Microsoft Azure」上で提供する画像および動画の解析サービスです。ディープラーニング(深層学習)の専門知識や大規模な計算環境を持たない企業であっても、API(アプリケーション・プログラミング・インターフェース)やSDK(ソフトウェア開発キット)を呼び出すだけで、システムやアプリケーションに視覚認識機能を組み込むことができます。
従来、人間が目視で行っていた確認作業やデータ入力作業をソフトウェアに代替させることで、業務プロセスの自動化を実現します。企業のシステムに組み込むことで処理できる主なタスクは以下の通りです。
- 画像やドキュメントからのテキスト抽出(光学文字認識)
- 写真や映像に写っている物体・人物・ブランドの検出および分類
- 画像全体や特定の領域に対する自然な説明文(キャプション)の生成
- カメラ映像を用いた空間内の人の動きや滞在時間の計測
これらの機能は、クラウド上での利用だけでなく、一部の機能はDockerコンテナーでも提供されています(公式のコンテナー文書ではRead OCRコンテナーが既存顧客向けに案内されており、Image Analysis APIの提供終了はコンテナーにも適用されます)。
旧Computer Visionから進化した背景
Azure AI Visionは、以前「Azure Cognitive Services」の「Computer Vision」という名称で提供されていたサービスが刷新・統合されたものです。Microsoftが展開するAIサービスのブランド再編に伴い、単機能のAPI群から、複数領域のデータを横断して扱うプラットフォームへと進化したとされています。
旧Computer Visionでは、文字認識、物体検出、カスタムモデルの構築(Custom Vision)などが個別の機能やエンドポイントとして分かれていました。Azure AI Visionへの再編で関連機能は整理されましたが、現在は上記の通り、機能ごとに提供終了や移行の案内が出ています。
旧サービスからの主な変更点は以下の通りです。
| 比較項目 | 旧Computer Vision | Azure AI Vision |
|---|---|---|
| 基盤モデル | タスクごとに個別の機械学習モデルを使用 | Florence基盤モデルに基づくと発表(公式ブログ。本記事では詳細未検証) |
| 自然言語との連携 | 事前定義された固定ラベルの検出が中心 | マルチモーダル埋め込み(画像とテキストのベクトル化)や密なキャプション(英語のみ)に対応 |
| カスタムモデルの学習 | 大量の教師データ(数十〜数百枚以上)の事前準備が必要 | モデルカスタマイズ(プレビュー)は2025年1月10日に提供終了。代替は公式の移行ガイドを参照 |
| 開発・検証環境 | 主にコードベースでのAPI呼び出しや個別ポータルでの操作 | 統合Webポータル「Vision Studio」によるブラウザ上での一貫した検証とモデル構築 |
この再編により、機能ごとの使い分けは整理されましたが、新規導入では提供終了の予定を踏まえ、代替手段を含めて設計する必要があります。
ノーコードで利用できるVision Studioの魅力
Azure AI Visionには、ブラウザ上で直感的に機能を試せるWebベースの統合環境「Vision Studio」が用意されています。従来のようにテスト用のプログラムコードを記述してAPIの応答を確認する必要がなく、画面上の操作だけで画像解析の精度や挙動を検証できます。
具体的には、手元にある製品の画像や帳票のデータをブラウザ画面にドラッグ&ドロップするだけで、文字の抽出結果や物体の検出枠(バウンディングボックス)、信頼度スコアが即座に視覚化されます。解析結果は視覚的なプレビューとJSON形式のテキストデータの両方で表示されるため、エンジニアだけでなく、企画部門や現場の担当者も交えて導入前の事前評価を行うことが可能です。
なお、Vision Studio上で自社独自の対象物を認識させるカスタムモデルをトレーニングする機能は、プレビューAPIの提供終了(2025年1月10日)に伴い、現在は利用できません。現行のVision Studioの案内は、OCR、Image Analysis(4.0・3.2)、Faceのクイックスタートです。
大規模視覚モデルFlorenceによる精度向上
Azure AI Visionの認識精度を支えているのが、Microsoftが開発した次世代のコンピュータビジョン基盤モデル「Florence(フローレンス)」です。従来の画像認識モデルが「画像と単語ラベルのペア」のみを学習していたのに対し、Florenceはインターネット上の膨大な「画像と自然言語の説明文のペア」を学習したマルチモーダル(複数種類のデータを統合処理する)モデルとして設計されています。
視覚情報と言語情報を同じ空間で結びつけて理解するアーキテクチャを採用しているため、視覚情報と言語情報を結びつけて扱う設計とされています(ゼロショット・フューショット学習の性能は、本記事では公式ドキュメントで確認できていません)。
Florenceの導入により、従来のモデルでは困難だった以下のような高度な処理が実用化されました。
- 画像全体を1つの文で説明するだけでなく、画像内の複数の注目領域それぞれに対して詳細な説明文を付与する「密なキャプション(Dense Captions)」の生成(公式では最大10領域。キャプションは英語のみ)
- 「赤い帽子をかぶって自転車に乗っている人」といった自然な文章(テキストプロンプト)を入力するだけで、膨大な画像や動画フレームの中から該当するシーンを直接抽出する検索機能(マルチモーダル埋め込みによる検索。公式の移行ガイドでは、画像埋め込みの代替としてCohere EmbedやSigLIPが挙げられています)
- 背景削除・前景の切り抜き機能は、2025年3月31日に提供終了しています(公式の概要ページ)
このように、単なる物体の有無の判定にとどまらず、画像内の状況や文脈を言語化してシステムに伝達できるようになったことで、画像解析の適用範囲が大きく広がっています。
Azure AI Visionが提供する主要機能
Azure AI Visionは、静止画から業務に必要な視覚情報を抽出する機能を提供しています。Microsoftが提供するAzure AI Visionの公式ドキュメントで確認できる各機能の対象データと出力結果は、以下の通りに整理できます(空間分析は提供終了のため除外しています)。
| 主要機能 | 解析対象データ | 主な出力データ・抽出結果 |
|---|---|---|
| OCR(光学式文字認識) | 風景写真、商品のラベル画像、スクリーンショットなど(PDFにはDocument Intelligenceを推奨) | テキストデータ、文字領域の座標(バウンディングボックス)、文字認識の信頼度スコア |
| 画像分析(Image Analysis) | 商品画像、Webコンテンツ用写真、現場の記録写真 | オブジェクト名と位置座標、コンテンツタグ、自然言語のキャプション、スマートクロップ座標 |
| 顔認識(Face API) | 人物の顔写真、本人確認用カメラ映像 | 顔の位置座標、顔のランドマーク(目・鼻・口の位置)、同一人物の一致度スコア、生体判定結果 |
画像やPDFから文字を抽出するOCR機能
OCR(光学式文字認識)機能は、画像に含まれる活字および手書き文字を検出し、デジタルテキストに変換します。公式ドキュメントでは、活字・手書きとも日本語に対応しています。1つの文書内の混在した言語も、言語を指定せずに扱えるとされています(言語を誤って指定すると不完全な結果になる場合があるため、確実な場合のみ指定する)。
公式ドキュメントによれば、現行の画像向けOCR(バージョン4.0)は、商品ラベル、ユーザー撮影の画像、スクリーンショット、看板、ポスターなど、文書ではない画像を対象にした高速な同期APIです。PDFやOfficeファイル、スキャン文書には、Document IntelligenceのReadモデルが推奨されています。出力される結果には、抽出された文字列、位置情報、単語ごとの信頼度スコアが含まれます。
請求書や納品書のような構造化された帳票のキーと値のペアや表データを抽出したい場合は、「Azure AI Document Intelligence」を選択します。レガシーのOCR API(v3.2)は、公式で使用が推奨されていません。
物体のタグ付けやキャプション生成を行う画像分析
画像分析(Image Analysis)は、画像内に写っている視覚的特徴を網羅的に解析し、メタデータや説明文を自動生成する機能です。開発者はAPIリクエスト時に必要な視覚特徴(Visual Features)を指定することで、1回の通信で複数の解析結果を同時に取得できます。具体的に抽出できる主な情報は以下の通りです。
- コンテンツのタグ付け:画像内に存在する物体、生物、背景の風景、アクションなど数千種類の認識対象から(日本語のタグ出力に対応)関連するキーワードと信頼度スコアを出力します。
- 物体検出(オブジェクト検出):タグ付けが画像全体に対するキーワードを返すのに対し、物体検出は「どの物体が画像のどの位置にあるか」を矩形のバウンディングボックス座標とともに返します。公式の言語表では、日本語(ja)の場合、物体検出に相当する列に対応の記載がなく、結果は英語になる可能性があります。
- キャプションおよび高密度キャプション(Dense Captions)の生成:画像全体の状況を説明する自然な文章を自動生成するだけでなく、画像内の複数の注目領域ごとに個別の説明文を出力します。(※公式ドキュメントでは、キャプション生成は英語のみ・一部リージョンのみで、日本語環境で利用する際はAzure AI Translatorなどの翻訳APIと連携させる構成が考えられます)
- スマートトリミング(Smart Cropping):SNSのサムネイルやWebサイトのバナーなど、指定したアスペクト比に合わせて画像を切り抜く際、人物や主要オブジェクトが欠けない最適なトリミング座標を算出します。
これらの機能は事前学習済みモデルとして提供されているため、開発者が独自の画像データを用意して機械学習モデルをトレーニングする作業は発生しません。
人物の属性や本人確認を行う顔認識API
顔認識(Face API)は、画像内の人間の顔を検出し、顔の位置、既定で27点の特徴点(ランドマーク)、顔の向き、メガネ・マスクの有無、遮蔽(オクルージョン)などを返します。検出した顔を使って、照合(Verification)や識別(Identification)、生体検知(Liveness)を行えます。なお、感情と性別の推定は提供終了しており、年齢・笑顔・ひげ・髪・化粧は利用が制限されています(公式)。
公式ドキュメントでは、2つの顔が同一人物かを判定する「照合(1対1)」と、リポジトリ内の顔から探し出す「識別(1対多)」が説明されています。さらに、入力された映像の顔が本物(ライブ)か偽物(なりすまし)かを判定するLiveness Detection(生体検知)が提供されています。ただし、生体検知のSDKは限定提供の機能で、利用するにはフォームでの申請が必要です。
なお、Face serviceへのアクセスは、Responsible AIの原則に基づき、適格性と利用基準によって制限されています。公式ドキュメントでは「Microsoftが管理する顧客とパートナーのみ」が利用でき、Face Recognitionの申請フォームから申請する必要があるとされています。顔の識別(Face ID)には承認が必要です。
空間分析(Spatial Analysis)は提供終了
空間分析(Spatial Analysis)は、防犯カメラのRTSP映像から人の動線や滞在を解析する機能でしたが、Microsoftのリタイア告知(Message Centerのアーカイブ)によれば、Edgeコンテナーは2025年3月30日に提供が終了しました。同告知は代替サービスを明示していません。現行の公式のAzure Vision概要にも空間分析は掲載されていないため、店舗の動線分析などの用途では、他社製品や自社開発を含めて検討する必要があります。
【業界別】Azure AI Visionの活用シナリオ10選
以下の10の活用パターンは、実在する企業の導入事例ではなく、画像解析で想定される使い方を整理した想定シナリオです。効果の数値は公式に裏付けがありません。また、前述の通り提供終了となった機能(カスタムモデル、空間分析など)に依存するものは、代替手段の検討が前提になります。
| 業界 | 活用シーン | 主に使用する機能 | 解決する業務課題 |
|---|---|---|---|
| 製造業 | 外観検査と不良品検知 | カスタム画像モデル(Image Analysisのカスタムは提供終了。代替手段が必要) | 検査基準の属人化、微細な初期不良の見落とし |
| 製造業 | 安全装備の着用確認 | 物体検出(装備品を検出できるかは要検証。カスタムモデルが必要な場合あり) | 労働災害の防止、現場監督者の巡回負担 |
| 小売業 | 顧客動線と混雑状況の分析 | 空間分析は提供終了(代替手段が必要) | 店舗レイアウトの最適化、レジ待ち時間の短縮 |
| 小売業 | 商品棚の欠品と陳列把握 | 物体検出(商品の判定には要検証。カスタムモデルが必要な場合あり) | 販売機会の損失防止、店員の棚チェック工数 |
| 物流業 | 伝票・ラベル読み取りと仕分け | OCR(Read) | 目視確認による誤配送、手入力のタイムロス |
| 金融業 | 本人確認(eKYC) | OCR、顔認識(Face) | 口座開設などの審査リードタイム長期化、なりすまし防止 |
| 医療分野 | 医療画像の解析と診断補助 | カスタム画像モデル(要検討。診断目的での利用は規制の確認が必要) | 医師の読影負担、初期病変の見落としリスク |
| 建設業 | ドローンを用いたインフラ点検 | カスタム画像モデル等(標準の物体検出で検出できるかは要検証) | 高所作業の危険性、広範囲の点検にかかる期間と費用 |
| メディア業界 | 画像・動画の自動タグ付け | 画像分析(タグ。キャプションは英語のみ)、マルチモーダル埋め込み | 過去素材の検索時間増大、手作業でのメタデータ付与 |
| 農業 | 生育モニタリングと収穫予測 | カスタム画像モデル(Image Analysisのカスタムは提供終了。代替手段が必要) | 熟練農家の経験への依存、収穫期における人員手配のズレ |
製造業での外観検査と不良品検知の自動化シナリオ
製造ラインのベルトコンベア上に設置した産業用カメラで製品を撮影し、カスタム画像モデルで表面に付着した異物や傷、塗装のムラ、印字の欠けなどを検出する構成が考えられます。ただし、Image Analysis 4.0のモデルカスタマイズ(プレビュー)は2025年1月10日に提供が終了し、Custom Visionも2028年9月25日までのサポートとされています。新規に設計する場合は、公式が挙げる代替手段(Azure Machine Learning AutoML、Foundryのモデル、Azure Content Understandingなど)を検討してください。
金属部品の加工工場や食品パッケージの検品ラインなどでは、検査員の疲労や経験値の差によって判定基準にばらつきが生じやすいことが課題になりがちです。正常品と不良品の画像を学習させた独自モデルをラインに組み込めば、一定の基準で異常を検知し、不良品の流出を減らすことを目指せます(検出精度は実際の画像での検証が必要です)。不良と判定された製品を別レーンへ排出する運用も考えられます。
製造業での工場内における安全装備の着用確認シナリオ
工場やプラントの入退室ゲートや危険区域の入り口に設置されたカメラ映像から、作業員がヘルメットや安全メガネなどの指定装備を着用しているかを自動判定する構成が考えられます。標準の物体検出でこれらの装備品を検出できるかは本記事では確認できていないため、実際の画像で検証し、必要に応じてカスタムモデルを検討してください。
現場監督者がすべての作業員の装備を目視で常時確認することは困難です。「人物」のバウンディングボックスと「ヘルメット」などの装備品の座標が適切な位置関係にあるかをシステム側で判定し、未着用者を検知した場合にゲート制御やアラートで通知する、といった設計が考えられます。
小売業での店舗内カメラによる顧客動線と混雑状況の分析シナリオ
スーパーマーケットやアパレル店舗の天井に設置された既存の防犯カメラ映像から、来店客の移動経路や特定の売り場での滞在時間、レジ前の待ち人数を計測する用途です。ただし、この用途を担っていた空間分析(Spatial Analysis)のEdgeコンテナーは2025年3月30日に提供が終了しており、同じ構成はできません。
従来は調査員がカウンターを持って立ち会い調査を行うか、専用センサーを新規に設置する必要がありました。他社製品や自社開発を含む代替手段で動線データを取得できれば、以下のような店舗運営の改善アクションにつなげられます。
- 顧客が素通りしやすい通路と、足を止めて商品を比較しているホットスポットを可視化し、特売品やPOPの配置を見直す
- レジ待ちの列が設定した人数(例:5人以上)を超え、かつ一定時間継続したことを検知して、バックヤードの従業員へ応援要請の通知を自動送信する
- 時間帯ごとの入店人数と購買データ(POSデータ)を突き合わせ、エリアごとの買上率を算出する
小売業での商品棚の欠品検知と陳列状況の把握シナリオ
店舗の棚を定点カメラや従業員のスマートフォンで撮影し、商品の欠品(棚空き)や指定された棚割り通りの陳列になっているかを解析する用途です。標準の物体検出で商品の欠品を判定できるかは要検証で、商品固有の認識にはカスタムモデルが必要となる場合があります。
小売現場では、バックヤードに在庫があるにもかかわらず、店頭への補充遅れによって販売機会を逃すケースが少なくありません。棚の画像を定期的に解析できれば、どの棚のどの商品が不足しているかを従業員の端末へ通知し、品出し作業の優先順位を明確化する運用が考えられます。
物流業での伝票やラベルのOCR読み取りによる仕分け効率化シナリオ
倉庫に入荷した段ボールやパレットに貼付されている配送伝票、送り状、荷札シールをカメラやハンディターミナルで撮影し、OCR機能で宛先住所、品名、管理番号、手書きの特記事項などのテキストを抽出する用途です。
物流現場では、取引先ごとに伝票のフォーマットが異なり、印字が傾いていたり、複数枚のラベルが貼られていたりするため、定型OCRでは読み取りエラーが起きやすいという課題があります。公式ドキュメントでは、現行の画像向けOCRは活字・手書きとも日本語に対応しています。ただし、読み取った文字列から宛先や管理番号などの項目を判別する処理は、アプリ側で実装する必要があります。PDFや構造化された帳票にはDocument Intelligenceが推奨されています。
金融業での本人確認書類の読み取りと顔認証によるeKYCシナリオ
銀行口座の開設やクレジットカードの申し込みをスマートフォン上で完結させるオンライン本人確認(eKYC)において、OCR機能と顔認識(Face API)を組み合わせて活用します。
従来は申込書と本人確認書類のコピーを郵送でやり取りしていたため、審査完了までに時間を要しました。Azure AI Visionを組み込む場合は、以下のような手順が考えられます。ただし、Face APIの利用や生体検知のSDKには申請が必要です。
- 利用者がスマートフォンで撮影した運転免許証やマイナンバーカードの画像から、OCR機能で文字を抽出し、氏名・生年月日・住所などの項目をアプリ側で判別して、申込フォームの入力内容と照合する
- 書類上の顔写真領域を切り出し、利用者がその場で撮影した自撮り(セルフィー)画像と顔認識機能で照合し、同一人物であるかを判定する
- 写真や画面を撮影しただけのなりすまし(プレゼンテーション攻撃)を防ぐため、自撮り時に生体検知(Liveness Detection)を実行し、実在する本人がカメラの前にいることを確認する
これにより、金融機関側の目視による確認作業の削減が期待できます。犯罪収益移転防止法が求める本人確認の要件をこの構成で満たせるかどうかは、本記事では検証していないため、所管官庁の資料や自社のコンプライアンス部門で確認してください。
医療分野での画像解析に関する注意点
医療画像の解析と診断補助については、Azure AI Visionの汎用の画像分析機能で実現できると確認できる公式の記述がありませんでした。診断目的のAIは、医療機器としての規制が関わる場合があります。
本記事では、医療画像の診断補助について具体的な構成や効果を示しません。検討する場合は、公式ドキュメントと関係法令、医療機関のガイドラインを個別に確認してください。最終的な確定診断は医師が行う前提です。
建設業でのドローン画像を用いたインフラ点検の効率化シナリオ
橋梁、トンネル、ダム、太陽光発電パネル、ビルの外壁などをドローンで撮影し、空撮画像からコンクリートのひび割れ(クラック)、鉄骨のサビ、ボルトの脱落などを自動抽出する用途です。これらは標準の物体検出で検出できるかが確認できていないため、カスタムモデルが前提になる可能性があります。
老朽化が進むインフラでは、足場を組んだり高所作業車を手配したりする従来の目視点検に、作業員の墜落リスクや仮設費用の課題があります。ドローンで撮影した画像を一括して解析できれば、AIが異常を検出した箇所のみを詳細調査する運用が考えられます。ただし、ひび割れの検出精度は撮影条件や画像の解像度に左右されるため、実際の画像での検証が必要です。
メディア業界での膨大な画像や動画アーカイブの自動タグ付けシナリオ
放送局、新聞社、出版社、ECサイト運営企業などが保有する数百万点規模の報道写真や動画アーカイブ、商品画像に対して、画像分析機能を用いて被写体のタグ(キーワード)や説明文(キャプション)を自動で付与します。
過去の映像素材や記事写真を再利用する際、人手でメタデータを入力していないデータは検索できず、アーカイブが死蔵してしまう問題があります。画像分析のタグ(日本語に対応)、著名人・ランドマークの検出、OCRによる看板の文字抽出などを統合的に使い、データベースへ自動登録する構成が考えられます。なお、キャプションは英語のみです。また、マルチモーダル埋め込みを使えば、自然言語のキーワードでの検索も考えられます。
農業での生育状況のモニタリングと収穫時期の予測シナリオ
ビニールハウス内の定点カメラや、圃場を巡回するスマートフォン・ドローンで撮影した農作物の画像を解析し、葉の色や大きさ、果実の数、色づき具合などを定量化する用途です。
農業分野では、水やりや追肥、収穫適期の判断が熟練農家の経験に依存し、新規就農者への技術継承が課題になっています。たとえばトマトやイチゴで、果実の色合いを段階別に学習させたカスタムモデルを使えば、区画ごとに収穫適期の実を自動でカウントし、収穫量を予測することを試みる構成が考えられます(検出・予測の精度は要検証です)。カスタムモデルの手段は、前述の通り代替が必要です。
ビジネスを加速させるAzure AI Visionの活用法とメリット
Azure AI Visionを業務プロセスに組み込むと、これまで人間の視覚と判断に依存していた確認・記録作業をプログラムで自動処理できるようになります。現場の労働力不足を補いながら業務の正確性とスピードを同時に引き上げる具体的なメリットと、実践的な活用アプローチを解説します。
目視作業の自動化による大幅なコスト削減と人手不足解消
製造ラインでの検品、紙帳票のデータ入力、監視カメラの常時モニタリングなど、従来は担当者が張り付いて行っていた目視作業をAIが代替します。カメラやスキャナーから取得した画像データをAzure AI Visionに送信するだけで、対象の検出や文字のテキスト化を自動化でき、確認作業にかかる工数の削減が期待できます(処理時間はAPIや画像によって異なります)。
特に深夜帯の稼働が求められる物流拠点や、24時間体制のインフラ監視業務においては、人員配置を抑えながら稼働を継続できる体制の構築を目指すことが可能です。単純な確認作業をシステムへ移行することで、現場の従業員は異常発生時の原因究明や顧客対応など、人間ならではの判断が求められるコア業務に集中できるようになります。
| 評価項目 | 人間による従来の目視作業 | Azure AI Visionによる自動化 |
|---|---|---|
| 稼働時間と処理速度 | シフト制による時間制限あり・1件あたり数秒〜数分 | システムは連続稼働が可能(処理時間はAPIや画像によって異なる) |
| 人件費・教育コスト | 採用費、継続的な人件費、作業手順の研修コストが発生 | API利用料やクラウドインフラ費用に加え、導入・運用の設計コストが発生 |
| 繁忙期の対応力 | 短期スタッフの増員や残業対応が必要 | レート制限の範囲内で大量データを処理可能(F0は毎分20件) |
ヒューマンエラーの防止と品質の均一化
人間が長時間の目視確認を続けると、疲労や集中力の低下による見落とし・誤読といったヒューマンエラーが避けられません。また、熟練者と新人の間で判断基準にばらつきが生じ、検査や確認の品質が属人化しやすいという課題もあります。
Azure AI Visionを活用すれば、あらかじめ定義されたアルゴリズムと信頼度スコア(Confidence Score)に基づいて、すべての画像データを同一基準で判定します。体調や経験年数に左右されない一貫したチェック体制を維持できるため、不良品の流出や入力ミスを未然に防ぎ、サービスや製品の品質を均一化できます。
より精度の高い運用を実現するには、AIが算出した信頼度スコアに応じた振り分けルールを設ける手法が有効です。例えば、スコアが90%以上のデータはシステムで自動承認し、70%〜89%のグレーゾーンに該当する画像のみを人間の目視確認へ回す(数値は一例で、基準はPoCで決めます)「Human-in-the-Loop(人間参加型)」のワークフローを構築することで、見落としリスクの最小化と確認工数の削減を両立できます。
既存のシステムやアプリケーションへの簡単なAPI組み込み
画像解析AIを自社でゼロから開発する場合、機械学習エンジニアの確保や膨大な学習データの収集、高価なGPUサーバーの構築に相応の期間を要することがあります。一方、Azure AI Visionはマイクロソフトが学習済みの基盤モデルをクラウド経由で提供しているため、REST APIまたは各種プログラミング言語(Python、C#、Java、JavaScriptなど)向けのSDKで、既存の業務システムやモバイルアプリに画像解析機能を追加できます(対応言語は公式で確認してください)。ただし、Image Analysis APIは2028年9月25日に提供終了が予定されています。
システム連携における具体的な実装パターンは以下の通りです。
- 社内の基幹システム(ERP)や在庫管理システムと連携し、スマートフォンで撮影した納品書や検品画像をAPI経由で送信してデータベースを自動更新する
- ローコード開発ツールのPower AutomateやAzure Logic Appsのコネクタ(提供状況は公式のコネクタ一覧で確認)を利用し、指定フォルダに保存された画像から文字を抽出してExcelやSharePointへ自動転記する
- Dockerコンテナーでの提供がある機能(Read OCRコンテナーなど。既存顧客向けの案内)は、ローカル環境で処理する構成も考えられる
インフラの保守やAIモデルのアップデートはAzure側で管理されるため、自社の開発チームは業務アプリケーション側の画面設計やデータ連携ロジックの実装に注力できます。
Azure AI Visionの料金体系と無料枠の仕組み
Azure AI Visionの料金には、「Free(F0)」と「Standard(S1)」の価格レベル(ティア)があります。料金は、APIの呼び出し回数(トランザクション)に応じて課金される仕組みです。ただし、Image Analysis APIは提供終了が予定されているため、新規導入では代替手段を含めた費用の検討が必要です。
公式の価格ページに掲載されている区分は、以下の通りです。確認できた時点のページは金額が表示されておらず、単価は確認できませんでした。金額は公式の価格ページと料金計算ツールで確認してください。
| 対象機能 | 価格レベル | 無料枠・段階区分 | 料金(米国ドル) |
|---|---|---|---|
| 画像分析(Image Analysis) | Free (F0) | 月間5,000トランザクションまで(毎分20件の制限あり) | 無料 |
| 画像分析(Image Analysis) | Standard (S1) | 0〜100万、100万〜1,000万、1,000万〜1億、1億超の段階(Group 1) | 金額は要確認(価格ページに表示なし) |
| OCR(Read) | Standard (S1) | 0〜100万、100万超の段階(Group 2) | 金額は要確認(価格ページに表示なし) |
無料枠の月間5,000トランザクション・毎分20件は、公式の価格ページに記載の画像分析の条件です。OCR(Read)のF0の条件は、確認できた価格ページで明記を確認できませんでした。最新のレートはMicrosoft Azure公式のAzure AI Vision価格ページで確認できます。
使った分だけ支払う従量課金制のメリット
Standard(S1)ティアが採用している従量課金制の最大の利点は、高性能なGPUサーバーの調達や維持管理にかかる初期投資を抑えて画像解析システムを稼働できることです。
自社で独自のAIモデルや推論用インフラを構築する場合、システムをほとんど使っていない夜間や閑散期であっても、サーバーの固定費や保守費用が毎月発生します。一方、Azure AI Visionの従量課金制であれば、APIを通じて画像を処理した分だけしか課金されないため、事業の成長フェーズや季節ごとの業務量の波に合わせてコストを柔軟に変動させられます。
具体的には、企業のシステム運用において以下のようなコスト最適化が実現します。
- 月末の請求書処理や繁忙期の検品など、特定の時期だけトランザクションが急増する業務でも、遊休期間の基本料金を支払う無駄がなくなる
- 大量利用時の割引プランの有無や内容は、確認できた公式の価格ページに記載がありませんでした。月間の処理件数が大規模になる場合は、販売窓口で確認してください
- Azureが提供する「料金計算ツール」や「Microsoft Cost Management」を活用することで、APIごとの日次・月次の消費コストを可視化し、予算上限のアラートを設定して想定外の課金を未然に防げる
無料で試せるFreeコンテナーの活用方法
本格的なシステム開発や本番導入の前に精度を確かめたい場合、無料枠であるFree(F0)ティアや、ローカル環境等で動かせるコンテナー機能を組み合わせることで、ライセンス費用を抑えて実データを用いた概念実証(PoC)を進められます。
Free(F0)ティアでは、画像分析は月間5,000トランザクションまで無料で呼び出せます。さらに、Azure AI Visionはクラウド上のAPIとしてだけでなく、Dockerコンテナーとしても提供されている機能があります(公式のコンテナー文書では、Read OCRコンテナーが既存顧客向けに案内されています)。
無料枠およびコンテナーを活用して検証を進める際は、以下の手順で進めるとスムーズです。
- AzureポータルでAzure AI Vision(Computer Vision)のリソースを作成する際、価格レベルとして「Free F0」を選択し、APIキーとエンドポイントURLを取得する
- コンテナーを利用した検証を行う場合は、Dockerがインストールされた環境にMicrosoft Container Registryから対象のイメージ(Read OCRコンテナーなど)をプルする
- コンテナーの起動時に、取得したAPIキーとエンドポイントを指定し、Azure側の課金エンドポイントと常に通信できる状態で実行する(公式文書で、課金エンドポイントとの通信が必須とされています)
公式のコンテナー文書では、コンテナーは課金情報をAzureへ送信する必要があり、解析対象の画像やテキストなどの顧客データはMicrosoftに送信されないとされています。コンテナーでの利用量と無料枠の扱いは、公式で確認してください。
ただし、無料枠を使って検証を行う際には、以下の制限事項を把握しておく必要があります。
- APIの呼び出し頻度が「1分あたり最大20トランザクションまで」に制限されるため、大量の画像を並列で一括処理するような負荷テストには対応できない
- レガシーのRead API(v3.2)でPDFやTIFFファイルを読み取る場合、最大2,000ページまで処理されるのに対し、無料枠では最初の2ページのみが処理される(公式)
- Free(F0)リソースを1つのサブスクリプション内で作成できる数の上限は、確認できた公式ページに記載がなく要確認
まずはFree(F0)ティアで自社の帳票や製品画像の認識精度を確認し、システム全体の処理速度や大量データのバッチ処理をテストする段階に入ったタイミングで、価格レベルをStandard(S1)へ切り替えるのが最も無駄のない導入手順です。
よくある質問(FAQ)
Azure AI VisionとAzure OpenAIのGPT系モデルはどう使い分ければいいですか?
Azure AI Visionは、特定のタスクを高速かつ低コストで大量に処理する用途に向いており、Azure OpenAIのマルチモーダルモデル(GPT-4oなどのGPT系モデル)は、画像全体の文脈理解や複雑な推論を伴う用途に適しています。業務の要件や予算に応じて、両者を単独で使うか、組み合わせて利用するかを判断します。
| 比較項目 | Azure AI Vision | Azure OpenAI(GPT系モデルなど) |
|---|---|---|
| 得意な処理 | 文字抽出(OCR)、物体検出(座標特定)、顔認識、空間分析 | 状況の要約、異常の理由推測、複雑な図表の解釈、対話型の質疑応答 |
| 応答速度(レイテンシ) | 一般に高速(処理時間はAPIや画像によって異なる) | 標準的(生成するテキスト量に応じて数秒かかる場合がある) |
| コスト構造 | 画像枚数やトランザクション単位の安価な従量課金 | 画像の解像度と入出力トークン数に応じた課金 |
| 出力形式の安定性 | 固定フォーマットのJSON(座標や信頼度スコアを厳密に返却) | 自然言語または指定したJSON形式(プロンプトによる制御が必要) |
両方のサービスを連携させる構成も考えられます。例えば、画像内の人物やオブジェクトの位置(バウンディングボックス)を取得する処理にはAzure AI Visionを使い、検知された画像だけをGPT系モデルへ送信して、状況を自然言語でレポート化するといった役割分担です。ただし、Image Analysis APIは2028年9月25日に提供終了が予定されています。Microsoftの移行ガイドは、画像分析の用途で、FoundryのGPT系モデルやAzure Content Understandingを選択肢として挙げています。
プログラミングの知識がなくてもAzure AI Visionは使えますか?
ブラウザベースのGUIツールである「Vision Studio」や、ローコード開発ツールの「Microsoft Power Automate」を活用することで、プログラミングの知識がない担当者でも検証や業務の自動化を行えます。
導入初期の精度検証(PoC)であれば、Vision Studioにアクセスし、手元の画像ファイルをドラッグ&ドロップするだけで、OCRの読み取り結果や物体検出の精度を画面上で即座に確認できます。さらに、日常業務の自動化に組み込みたい場合は、ローコード連携の仕組みも考えられます(コネクタの対応状況は公式で確認してください)。
- メールに添付された画像をトリガーにして、Power Automate経由で文字情報を自動抽出する(PDFの請求書にはDocument Intelligenceを検討する)
- 抽出したテキストデータをMicrosoft ExcelやSharePointのリストへ自動的に転記・保存する
- Power Appsで作成したスマートフォン用アプリから現場の写真を撮影し、画像内の対象物を判定して結果を画面に表示する
ただし、業務の基幹システムへ直接組み込む場合や、1日に数万枚規模の画像をバッチ処理するような本格的なシステム開発においては、PythonやC#などのプログラミング言語を用いてREST APIやSDKを呼び出す実装が必要です。
アップロードした画像データがAIの学習に勝手に使われることはありませんか?
確認できたMicrosoft Learnの公式ドキュメント(Read OCRのデータ・プライバシー・セキュリティ)では、入力データと結果は24時間以内に削除され、他の目的には使用されないと記載されています。ただし、Image Analysisなど他の機能のページは確認できておらず、基盤モデルの学習への利用有無に関する明確な記述も確認できなかったため、本記事では断定しません。契約条件やMicrosoft Trust Centerで確認してください。
Read OCRについて、公式ドキュメントAzure AI Vision のデータ、プライバシー、セキュリティで確認できた内容は以下の通りです。社外秘の設計図や個人情報を含む画像を扱う場合は、契約条件や社内規程に照らして確認してください。
自社の独自製品を認識させるようなカスタマイズは可能ですか?
以前はVision Studio上でカスタム画像分類・物体検出のモデルを作成できましたが、Image Analysis 4.0のモデルカスタマイズ(プレビュー)は2025年1月10日に提供が終了しました(Microsoftのリタイア告知)。公式の移行ガイドでは、カスタムの画像モデルや分類には、FoundryのGPT系モデルやAzure Content Understanding(公式ドキュメントでは当時プレビューと記載)が代替手段として挙げられています。
Azure Custom Visionについては、公式ドキュメントで、2028年9月25日までがフルサポート期間とされています。カスタムモデルの代替として、公式はAzure Machine Learning AutoML(画像分類と物体検出のカスタムモデル)、Foundryのモデルカタログの生成モデルを使った自前のソリューション、Azure Content Understandingを挙げています。
したがって、これから新規に開発を始める場合は、Custom Visionも含めて提供終了の予定を踏まえ、公式の移行ガイドを確認しながら代替手段を選ぶことをおすすめします。具体的な精度や必要な学習データの量は、本記事では公式ドキュメントで確認できていないため、実際の画像で検証してください。
インターネットに接続できない環境でも利用できますか?
工場内の閉域網や医療機関の院内ネットワークなど、外部インターネットへ画像データを送信できない環境では、Dockerコンテナーでの提供がある機能であれば、ローカル環境での処理を検討できます。ただし、Image Analysis APIの提供終了(2028年9月25日)はコンテナーにも適用されます。
公式のコンテナー文書では、Read OCRコンテナーが既存顧客向けに案内されています。空間分析のEdgeコンテナーは、2025年3月30日に提供が終了しました。
また、公式ドキュメントでは、コンテナーは課金エンドポイントと常に通信する必要があり、接続できない状態が続くとリクエストの処理を停止するとされています(エアギャップ環境での運用には別途の条件が必要な場合があります)。一方、コンテナーは画像やテキストなどの顧客データをMicrosoftに送信しないと説明されています。
まとめ
本記事では、Azure AI Visionの主要機能や業界別の活用シナリオ、料金体系、提供終了の予定を解説しました。
- OCR、画像分析、顔認識などの機能があり、Image Analysis APIは2028年9月25日に提供終了予定
- 想定シナリオとして、外観検査やOCRによる伝票読み取りなど、目視作業の自動化によるコスト削減と品質均一化を目指せる(効果は検証が必要)
- API連携で既存システムに組み込め、Vision Studioならノーコードで試せる
- 従量課金制と無料枠があり、小規模な検証から開始可能
まずは無料枠やVision Studioを活用して、自社の業務データで画像解析の精度を確認しつつ、提供終了の予定を踏まえた代替手段も含めて検討してみましょう。