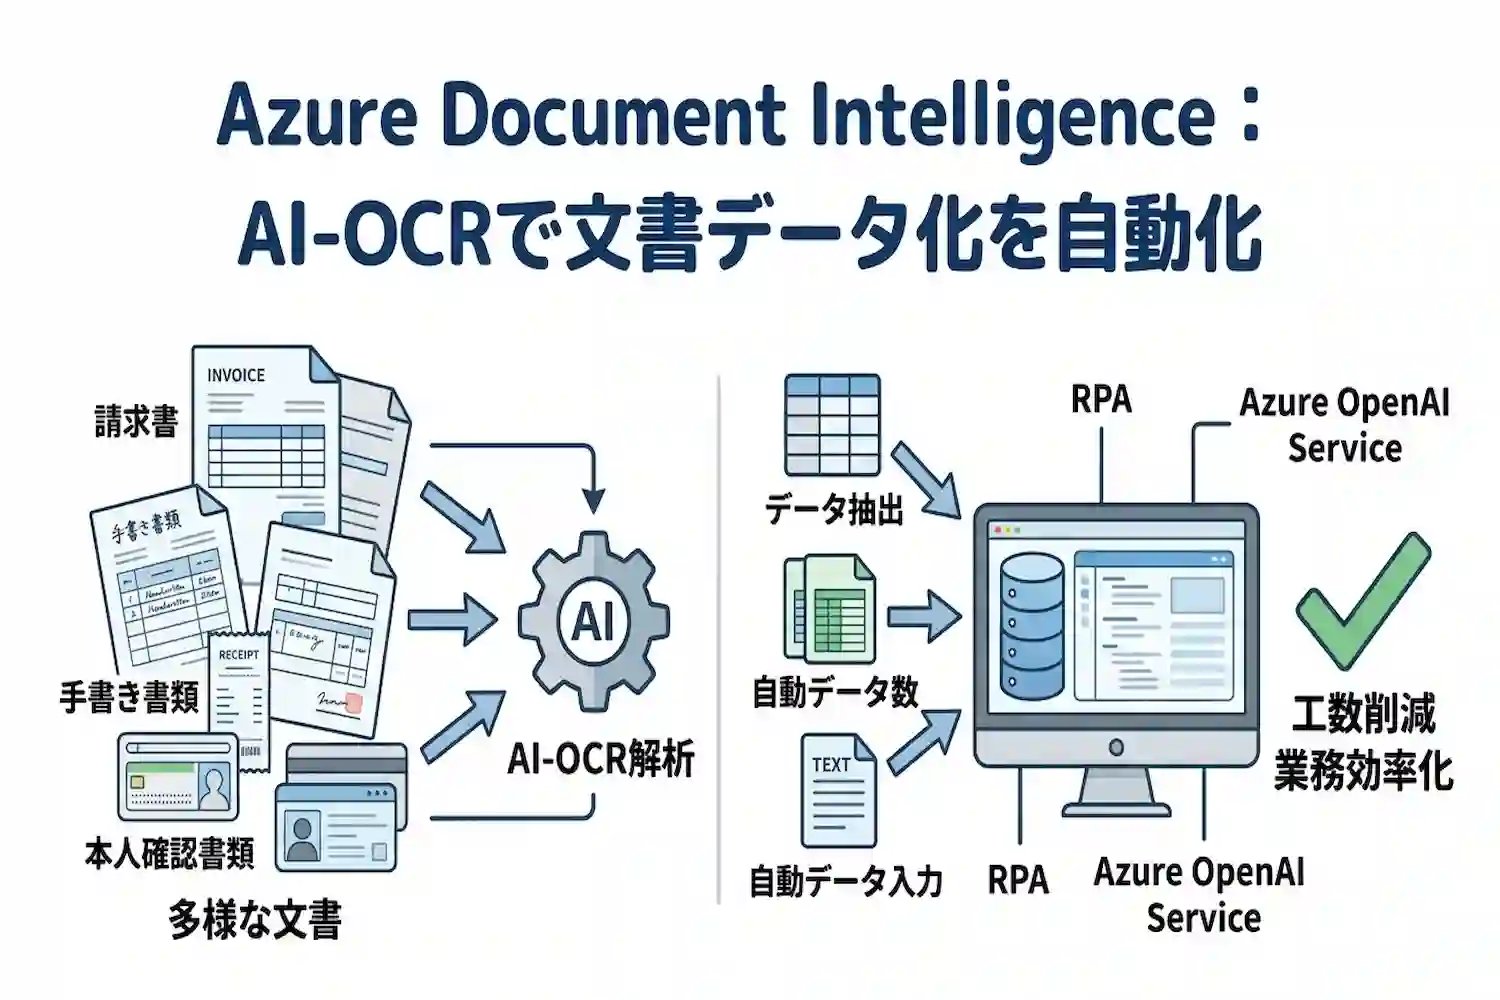
Azure Document Intelligence(旧Form Recognizer)は、AI-OCRを用いて文書からテキストや表構造を抽出し、データ入力を自動化するサービスです(Microsoft Learnでの現在の正式表記は「Azure Document Intelligence in Foundry Tools」)。
この記事で分かること
- 事前構築済みモデルとカスタムモデルの使い分け
- 請求書処理や契約書管理などを自動化する5つの業界別活用シナリオ(想定例)
- Document Intelligence Studioを用いた精度検証から導入までの手順
- 料金体系やデータの取り扱いに関する仕様
フォーマットが異なる帳票もデータ化でき(手書き文字の対応言語は公式の言語サポート表で確認)、RPAやAzure OpenAI Serviceと連携することで、目視確認や手入力の工数を削減できます。自社の業務に適用できるか判断するための機能や導入手順を確認しましょう。
Azure Document Intelligence(旧Form Recognizer)とは
Azure Document Intelligenceは、マイクロソフトのクラウドプラットフォームであるMicrosoft Azureが提供する、AIを活用したドキュメント解析サービスです。以前は「Azure Form Recognizer」という名称で提供されていました(Microsoftのコネクタ文書にも「formerly Form Recognizer」と記載されています)。名称変更の理由については、本記事では断定しません。ブラウザ上のツールであるDocument Intelligence Studioでは、コードを書かずにサンプル文書の解析結果を試せます。一方、自社の業務フローへ組み込む場合は、REST APIやSDKを使った開発(またはPower Automateなどのローコードツール)が必要です。
文書からテキストや構造を抽出するAI-OCRサービス
従来のOCR(光学的文字認識)ソフトウェアは、画像内の文字をテキストデータへ変換する機能に特化しており、事前の座標指定なしに項目の意味やデータの関連性を判別することは困難でした。これに対し、AI-OCRであるAzure Document Intelligenceは、AIモデルを用いて文書の視覚的な特徴とテキストの文脈を同時に解析します。
PDFや画像ファイル(JPEG、PNG、BMP、TIFF、HEIFなど)、Microsoft Office文書(Word、Excel、PowerPoint、HTML)を入力すると、文字のテキスト化にとどまらず、見出しや段落などの文書構造、表(テーブル)の行・列構造、チェックボックスの選択状態までを構造化データ(JSON形式、レイアウトモデルではMarkdown形式も選択可)として出力します。「請求金額:10,000円」といったキーと値のペア(Key-Valueペア)は、請求書などの事前構築済みモデルの抽出項目や、解析時のオプション機能(keyValuePairs)で扱います(レイアウトモデルの解説ページにはキーと値のペアの記載がなく、扱いは要確認です)。これにより、企業の担当者が紙の帳票を目視で確認しながら基幹システムへ手入力する作業を削減できます。
具体的に解析・抽出できる主な要素は以下の通りです。
- 印刷された活字および手書き文字(対応言語は公式の言語サポート表で確認。日本語の手書きへの対応は本記事では未確認)
- 結合セルやヘッダーを含む複雑な表(テーブル)のレイアウト情報
- 帳票内の項目名(キー)と、それに対応する入力値(バリュー)の関連付け(事前構築済みモデル等で対応)
- チェックボックスなどの選択マークの「選択・未選択」の判別
事前構築済みモデルとカスタムモデルの使い分け
Azure Document Intelligenceには、用途に応じて選択できる複数のAIモデルが用意されています。大きく分けると、マイクロソフトが学習済みの状態で提供する「汎用ドキュメント分析モデル」「事前構築済み(Prebuilt)モデル」と、ユーザー自身が独自の帳票を学習させる「カスタム(Custom)モデル」の3種類が存在します。業務で扱う文書の性質に合わせてこれらを使い分けることで、開発期間とコストを最適化できます。
| モデルの種類 | 特徴と仕組み | 主な対象文書・用途 |
|---|---|---|
| 汎用ドキュメント分析モデル (読み取り / レイアウト) |
文書全体のテキスト、段落、表構造、選択マークなどを抽出する基礎的なモデル。事前の学習作業は不要。 | 一般的なビジネス文書、技術資料、レポート、RAG(検索拡張生成)用の元データ作成 |
| 事前構築済みモデル (Prebuilt) |
世界中で広く使われている標準的な帳票フォーマットを学習済み。導入した当日から特定項目の抽出が可能。 | 請求書、領収書、本人確認書類(公式の対応書類はパスポート、米国・インド・オーストラリア等の運転免許証など。日本の書類は要検証)、契約書(事前構築済みの契約書モデルは英語(米国)のみ)、米国税務フォームなど |
| カスタムモデル (Custom) |
自社独自の帳票フォーマットや業界特有の書類を、最低5枚のサンプルデータから追加学習させて構築するモデル。 | 自社指定の申込書、独自の点検記録表、定型のアンケート用紙、業界固有の伝票など |
たとえば、取引先ごとに書式が異なる請求書から「請求日」「合計金額」「明細行」を抜き出したい場合は、事前構築済みの「請求書モデル」をそのまま呼び出すだけで対応可能です。一方、自社独自のレイアウトで作成された紙のサービス申込書から特定の記入欄を抽出したい場合には、少量のサンプルにラベル付け(アノテーション)を行って「カスタムモデル」を作成する、といった判断基準で選択します。なお、請求書モデルの日本語対応は公式の言語サポート表で確認し、実際の請求書で検証してください。
Azure OpenAI Serviceとの連携による高度なデータ活用
近年、Azure Document Intelligenceの利用用途として急速に拡大しているのが、生成AI(大規模言語モデル:LLM)を提供する「Azure OpenAI Service」との連携です。企業の社内文書をもとに生成AIが回答を作成するRAG(Retrieval-Augmented Generation:検索拡張生成)システムを構築する際、回答の正確性を左右するのは「元となる文書データをいかに正確な構造でAIに読み込ませるか」という点にあります。
一般的なテキスト抽出ツールでPDFを読み込むと、段組みの順序が崩れたり、表の縦横の関係性が失われたりして、生成AIが誤った解釈をする原因となります。そこで前処理としてAzure Document Intelligenceのレイアウトモデルを使用すると、文書内の見出しレベルや表のセル構造を維持したまま、LLMが理解しやすいMarkdown形式へ直接変換できます(API v4.0 GAでは、結合セルを表現するため表はHTMLテーブル形式で出力されます)。
さらに、構造化したデータを検索エンジンである「Azure AI Search」に格納し、意味的な類似性を検索するセマンティック検索やベクトル検索と組み合わせることで、数十ページに及ぶ業務マニュアルや複雑な規定集からでも、ユーザーの質問に対する正確な根拠を抽出し、Azure OpenAI Serviceを通じて自然な日本語で回答を生成するシステムを構築できます。
Azure Document Intelligenceの活用シナリオ5選
Azure Document Intelligenceは、業界ごとに異なる多様な帳票や書類の処理業務で、目視確認や手入力の工数を削減する用途が想定されます。以下の5つは、実在する企業の導入事例ではなく、公式ドキュメントで確認できる機能を前提に構成した想定シナリオです。削減時間や短縮期間といった効果は公式に裏付けがないため、数値は示していません。自社で使えるかは、PoCで測定して判断してください。
| 業界 | 対象帳票 | 利用機能・モデル | 期待される効果(想定) |
|---|---|---|---|
| 製造業 | 取引先ごとの非定型な請求書・納品書 | 事前構築済み請求書モデル | 手入力・突合の工数削減と月次決算の早期化が見込める(削減幅は要検証) |
| 金融業 | 本人確認書類(日本の書類への対応は要検証) | IDドキュメントモデル(日本の書類は要検証)、またはカスタム抽出モデル | 目視確認の負担軽減と審査期間の短縮が見込める(要検証) |
| 自治体・公共 | 手書きの各種申請書・住民アンケート | カスタム抽出モデル・レイアウトモデル | 手入力の負担軽減と集計作業の迅速化が見込める |
| 不動産業 | 賃貸借契約書・重要事項説明書 | カスタム分類モデル・レイアウトモデル | 条項の確認・転記の負担軽減が見込める(最終判断は人が行う) |
| 保険業 | 医療機関ごとの領収書・診療明細書・診断書 | 事前構築済み領収書モデル・カスタム抽出モデル | データ入力の省力化と査定業務の標準化が見込める |
シナリオ1 請求書処理の自動化で経理業務の工数削減を目指す(製造業)
多数の部品メーカーや商社と取引を行う製造業では、毎月数千枚にのぼる請求書や納品書の処理が経理部門の負担になりやすい業務です。取引先によって帳票のフォーマットが異なり、従来の座標指定型OCRでは帳票ごとに読み取り位置のテンプレートを作成・維持する必要があったため、自動化が進みにくいという課題があります。
この課題に対しては、事前構築済みの請求書(Invoice)モデルを使い、PDFやスキャン画像から「請求元企業名」「請求日」「品目ごとの単価・数量・金額」「合計金額」「消費税額」などを抽出する方法が考えられます。抽出できる項目は公式の請求書モデルのスキーマで確認できます。適格請求書発行事業者登録番号を取得できるかは、確認できた公式ドキュメントに記載がなかったため、実際の請求書で検証してください。事前構築済みモデルは帳票ごとのテンプレート設定を前提としないため、新規取引先の請求書でも、事前のテンプレート設定なしで抽出を試せます。
さらに、抽出したJSON形式のデータをPower Automateなどを介して基幹システム(ERP)の買掛金モジュールへ連携し、発注データとの突合まで自動化する構成も考えられます。AIの信頼度スコア(Confidence Score)が基準値を下回った項目のみを画面上で目視確認する運用にすれば、確認工数の削減が期待できます。ただし、削減できる時間は帳票の品質や件数によって変わるため、PoCで測定してください。
シナリオ2 本人確認書類のデータ化で口座開設の手続き負担を減らす(金融業)
銀行の口座開設や証券会社の取引開始、クレジットカードの発行では、犯罪収益移転防止法に基づく本人確認が求められます。スマートフォンから申込者がアップロードした運転免許証やマイナンバーカードの画像を、バックオフィス部門のオペレーターが目視で確認し、申込フォームの入力内容と照合する運用では、審査完了までに時間がかかり、手続きの途中離脱が課題になりがちです。なお、オンライン完結の本人確認(eKYC)として認められる方式には法令上の要件があります。OCRの導入だけで要件を満たすかどうかは本記事では検証していないため、所管官庁の資料や自社のコンプライアンス部門で確認してください。
Document IntelligenceのIDドキュメント(ID Document)モデルについて、公式ドキュメントが挙げる対応書類は、パスポート(ブック/カード)、米国・インド・オーストラリアなどの運転免許証や身分証などです。日本の運転免許証やマイナンバーカードへの対応は、確認できた公式ドキュメントに記載がありません(「その他」区分にも国名の指定がありません)。日本の書類を扱う場合は、実物に近いサンプルでStudioによる検証を行い、読み取れない場合はカスタム抽出モデルの利用を検討します。抽出項目は、氏名、生年月日、書類番号、有効期限などで、住所は運転免許証のみが対象です。公式の項目表に交付年月日は見当たらないため、必要な場合は別の方法で取得できるか確認してください。
撮影品質は精度に影響します。公式ドキュメントでは、書類1点につき鮮明な写真または高品質なスキャン1枚を提供すること、抽出対象の文字の高さが1024×768ピクセルの画像で12ピクセル以上(150dpiで約8ポイント相当)であること、画像サイズが50×50〜10,000×10,000ピクセルであることが目安として示されています。この条件を踏まえて撮影ガイドを用意し、信頼度が低いケースや入力内容と書類記載が一致しないケース、有効期限切れのケースのみオペレーターが確認する運用を設計します。
シナリオ3 紙の申込書やアンケートのテキスト化を省力化する(自治体・公共)
地方自治体や公共機関では、各種給付金の申請書、施設利用の申込書、住民向けのアンケートなど、手書きの紙帳票が依然として多く利用されています。これらの書類は記載者の筆跡に癖があったり、記入枠からはみ出して書かれていたりすることが多く、職員や短期雇用のオペレーターが1枚ずつ目視でシステムへ手入力しているケースでは、予算の圧迫や入力ミスによる手戻りが課題になりがちです。
この業務の効率化に向けては、自治体独自の申請書フォーマットを学習させたカスタム抽出モデルと、チェックボックスの選択状態を判別するレイアウトモデルを組み合わせる構成が考えられます。対象帳票から、以下の要素を抽出する想定です。ただし、日本語の手書き文字への対応は公式の言語サポート表で確認し、マス目に沿った数字やフリガナの認識精度は、実際の帳票でStudioを使って検証してください。
- 申請者の氏名、フリガナ、住所、電話番号などの手書き文字列
- マイナンバーや口座番号などのマス目(記入枠)に沿って記入された数字
- 申請理由やアンケートの設問に対するチェックボックス(レ点や塗りつぶし)の選択有無
- 自由記述欄に記入された複数行にわたる要望や意見のテキスト
公式ドキュメントでは、カスタム抽出モデルは同じ形式の文書5枚程度から始められるとされています(画質が低い場合は、より多くのサンプルを推奨)。年度ごとに様式が変更される場合は、ラベル付けと再トレーニングが必要になります。手書き文字やチェックマークはJSONなどの構造化データとして取得でき、CSVへの変換などは自前の処理で行います。これにより、職員がデータの集計や分析、住民への給付業務に注力できる体制づくりにつながります。
シナリオ4 複雑な契約書から重要項目を抽出しリーガルチェックを補助する(不動産業)
店舗やオフィスビルの開発・管理を行う不動産会社では、オーナーやテナントと交わす賃貸借契約書や重要事項説明書が膨大な数にのぼります。契約書は数十ページにわたる長文であり、かつ相手方のひな形を使用する場合には条項の順序や表現がすべて異なります。法務担当者や営業管理部門が契約更新時期や賃料改定条件、中途解約時の違約金条項などをすべて目視で確認し、契約管理台帳へ転記する作業には多大な時間を要しがちです。
この課題に対しては、複数種類の契約書を振り分けるカスタム分類モデルと、段落や表の構造を把握するレイアウトモデル、特定の条項を抜き出すカスタム抽出モデルを組み合わせる構成が考えられます。なお、事前構築済みの契約書モデル(prebuilt-contract)は、公式の言語サポート表では英語(米国)のみのため、日本語の賃貸借契約書ではカスタムモデルの利用が前提になります。スキャンされた契約書PDFから、主に以下の項目を抽出して契約管理システムへ登録する想定です。
- 契約当事者(賃貸人・賃借人)の名称および代表者名
- 対象物件の所在地、面積、用途制限
- 契約期間、契約開始日、更新の条件(自動更新の有無や事前通知期限)
- 月額賃料、共益費、敷金・保証金の金額および返還条件
- 中途解約予告期間、違約金の算定基準、原状回復義務の範囲
解析結果には、抽出した値が文書のどのページのどの位置にあるかを示す座標情報(バウンディングポリゴン)が含まれます。そのため、アプリ側でハイライト表示を実装すれば、抽出された条項の根拠箇所を画面上で確認できる仕組みを作れます。ただし、ページをまたぐ表や段組みの認識精度は帳票によって異なるため、PoCで確認してください。条項の解釈や最終的なリーガルチェックは、必ず法務担当者が行う前提です。
シナリオ5 医療費領収書や診断書の読み取りで保険金支払いの事務を効率化する(保険業)
生命保険会社や損害保険会社の保険金支払い部門では、契約者から郵送またはウェブ経由で提出される医療機関の領収書、診療明細書、医師の診断書をもとに支払査定を行っています。これらの書類は病院やクリニック、調剤薬局ごとに発行システムが異なり、サイズやレイアウトが統一されていません。さらに、診断書には医師の手書きによる傷病名や治療経過が含まれるほか、病院の領収印が文字の上に重なって押印されているケースが多く、従来のOCRでは読み取りエラーが起きやすいという課題があります。
この課題に対しては、事前構築済みの領収書(Receipt)モデルと、医療特有の項目を学習させたカスタム抽出モデルを併用し、査定システムへのデータ入力を自動化する構成が考えられます。具体的には、「医療機関名」「受診日(入院期間・通院日)」「患者氏名」「保険診療点数」「自己負担額」に加え、診断書に記載された「傷病名」「手術名」「先進医療の有無」を抽出する想定です。ただし、領収書モデルが日本の医療機関の領収書や診療明細書に対応するかは、確認できた公式ドキュメントには記載がありません(領収書モデルの言語表には日本語が含まれています)。実際の書類での検証が必要です。
印影が文字に重なる書類や、斜めに撮影された領収書への対応は、読み取り精度に影響し得ます。確認できた公式ドキュメントには印影や傾き補正への明確な記載がなかったため、実際の書類でPoCを行ってください。抽出した金額の合計と明細の積み上げ計算が一致するかをシステム側で自動検証し、矛盾がない少額請求のみを自動承認に回す設計(ストレート・スルー・プロセシング、STP)も考えられます。ただし、保険金の支払可否は査定担当者や社内規程に基づいて判断し、AIの出力だけで確定させない運用を前提にしてください。
活用シナリオから見るAzure Document Intelligenceのメリット
各シナリオに共通するのは、単なる文字のデータ化にとどまらず、業務プロセス全体の自動化を目指している点です。従来のOCRツールでは対応が難しかった帳票のばらつきやシステム連携の課題に、Azure Document Intelligenceがどう役立つのかを、3つのメリットから解説します。
非定型帳票や手書き文字に対する高い認識精度
従来のOCR製品では、読み取り位置を座標で事前に指定する「テンプレート型」が主流であり、取引先ごとに異なるフォーマットの帳票を処理するには膨大な初期設定が必要でした。これに対し、Azure Document IntelligenceはAIモデルを採用しており、事前の座標指定なしで文字や項目を自動特定できる点が大きな強みです。
請求書や領収書のように発行元によってレイアウトが異なる非定型帳票であっても、AIが文脈や配置から「請求日」「合計金額」などのキーと値のペア(キーバリューペア)を推測して抽出します。なお、撮影時の傾き・影・折り目などは精度に影響し得るため、公式の画像品質の目安を参考に、実際の書類でPoCを行ってください。
日本語の手書き文字への対応と精度は、公式の言語サポート表で対応言語を確認し、実際の帳票で検証してください。抽出された各項目には、予測が正しい確率の推定値として「信頼度スコア(Confidence Score)」が0から1の数値で付与されます。公式ドキュメントでも、精度が重要な場面では、信頼度を使って自動承認するか人のレビューに回すかを判断できるとされており、スコアが基準値未満の項目だけを目視確認に回す運用が可能です。これにより、担当者がすべての書類を最初から突き合わせる必要がなくなり、確認作業の工数削減が期待できます。
| 比較項目 | 従来のテンプレート型OCR | Azure Document Intelligence |
|---|---|---|
| 非定型帳票への対応 | 帳票の様式ごとに読み取り座標の事前設定が必要 | AIが構造を解析するため、座標設定なしで抽出可能 |
| 手書き・傾きへの耐性 | 枠からはみ出た文字や斜めにスキャンされた画像で精度が低下しやすい | 手書き文字にも対応(対応言語・精度は要検証)。ページの回転角度が結果に含まれる |
| 確認作業の範囲 | 誤認識を前提に、原則として人間が全件・全項目を目視で照合 | 信頼度スコアが低い項目のみを抽出して人間が確認(例外処理の効率化) |
ドキュメントレイアウトや表構造の正確な理解
業務文書には、テキストだけでなく複雑な表(テーブル)や選択項目が含まれています。文字だけを羅列して抽出するツールでは、表の「どの行とどの列が対応しているか」という構造が崩れてしまい、後工程でエクセルやデータベースに転記する際に手直しが発生していました。
Microsoftの公式ドキュメント(レイアウトモデルの概要)で示されている通り、Azure Document Intelligenceは文書の視覚的な配置や構造をそのまま解析し、データ化する機能を備えています。具体的には以下のようなレイアウト要素を正確に識別します。
- セル結合や複数行にわたる明細行を含んだ複雑な表(テーブル)の行・列構造
- 申込書や問診票におけるチェックボックスなどの選択マークの状態(選択済み・未選択の判定)
- 契約書や規程集における段落やセクションなどの文書構造
- 複数ページにまたがる長文ドキュメントの連続性とページ単位の区切り
さらに、抽出したレイアウト情報をMarkdown形式で出力する機能も搭載されています。文書の構造や表を保ったままMarkdown化できるため、社内文書を検索して回答を生成するRAG(検索拡張生成)システムの構築で、前処理の工数を減らす用途に活用できます。なお、Excel(XLSX)を入力した場合は、表の解析に対応しないと公式ドキュメントに記載されています。
既存の業務システムやRPAとのスムーズなAPI連携
どれほど文字の認識精度が高くても、抽出されたデータが独立した画面やCSVファイルにとどまっていては、基幹システムへの転記作業が残ってしまいます。Azure Document Intelligenceは、主な機能はREST APIおよびSDK(公式ドキュメント上はC#/.NET、Java、JavaScript、Python)を通じて利用でき、既存の業務システムへ直接組み込むことが可能です。
APIのレスポンスは、システム開発で扱いやすいJSON形式で返却されます。抽出されたテキスト、テーブル構造、座標位置、信頼度スコアが整理された状態で取得できるため、会計システム、ERP、CRM(顧客管理システム)などのデータベースへ自動登録するパイプラインをスムーズに構築できます。
また、プログラミングによる開発を行わない場合でも、Power AutomateやLogic Appsには、Document Intelligenceの専用コネクタが用意されています。UiPathやAutomation AnywhereなどのRPAツールとの連携については、本記事では公式情報を確認できていないため、各製品のドキュメントで確認してください。ファイルサーバーへの帳票保存をきっかけに、AI-OCR処理から基幹システムへの入力、担当者への通知までを自動化するワークフローも、Power Automateなどを使って構築できます。
業務効率化を成功させるAzure Document Intelligenceの導入ステップ
Azure Document Intelligenceを実務に導入して期待通りの業務効率化を実現するには、事前の業務整理から検証、本番運用後のメンテナンスまでを計画的に進める必要があります。システム開発を伴う前に、まずは現場の課題を数値化し、スモールスタートで段階的に適用範囲を広げていく手順を解説します。
対象業務の洗い出しとROI(投資対効果)の試算
導入の第一歩として、社内で発生している紙帳票やPDFファイルなどのドキュメント処理業務を棚卸しし、自動化の対象とする業務を選定します。すべての帳票を一度に自動化しようとすると開発期間や初期コストが膨らむため、投資対効果(ROI)が高い業務から優先順位をつけることが重要です。
対象業務を選定する際は、以下の評価軸を用いて現場の作業負荷と帳票の特性を整理します。
- 月間の処理枚数と1枚あたりの手入力・目視確認にかかっている作業時間
- 取引先ごとのフォーマットのばらつき度合い(定型・準定型・非定型)
- 印字テキストと手書き文字の比率、およびスキャン画像の解像度や品質
- 抽出後のデータを連携する後続システム(基幹システム、会計ソフト、RPAなど)の仕様
対象業務の候補が絞れたら、現状の業務コストと導入後の削減効果を比較してROIを試算します。Azure Document Intelligenceは処理したページ数に応じた課金(価格は1,000ページ単位で公式の価格ページに掲載)のため、月間の処理枚数からランニングコストを見積もることが可能です。ただし、AI-OCRの導入後も人間による最終確認や例外処理は残るため、手入力作業が100%ゼロになる前提ではなく、目視確認や修正の工数を考慮して現実的な削減時間を算出することが失敗を防ぐポイントです。
ROIを試算する際は、以下の項目を対比させて費用対効果を検証します。
| 算出区分 | 主な評価項目 | 試算時の確認ポイント |
|---|---|---|
| 導入・運用コスト(投資額) | API利用料、システム連携開発費、初期学習コスト | 対象帳票の月間ページ数、利用するモデルの種類、後続システムとの接続方式(Power Automateや個別開発など) |
| 期待される効果(回収額) | 入力作業時間の削減、残業代の圧縮、確認ミスの防止 | 現状の作業時間(分/枚)×月間処理枚数×担当者の時間単価、およびリードタイム短縮による業務上のメリット |
Document Intelligence Studioを用いた精度検証(PoC)
対象業務と目標とするROIが定まったら、システム開発に着手する前に「Document Intelligence Studio」を用いて読み取り精度の検証(PoC:概念実証)を実施します。Document Intelligence Studioは、Webブラウザ上でサンプルの帳票ファイルをアップロードするだけで、文字認識や構造抽出の精度をノーコードでテストできる開発・検証環境です。なお、公式ドキュメントによれば、機能はDocument Intelligence StudioからFoundryポータルへ移行中で、2024年11月以降に公開された機能などはFoundryポータルの利用が案内されています。最新の入口は公式のStudio概要で確認してください。
PoCは、実際の業務で発生する多様なパターンの帳票サンプルを用意し、以下の手順で進めます。
- AzureポータルでDocument Intelligenceのリソースを作成し、Studioにサインインする
- 解像度の低いFAX受信データや、傾き・かすれのあるスキャン画像など、現場で実際に扱う品質のサンプル文書を準備する
- まずは学習不要な「レイアウトモデル」や「事前構築済みモデル(請求書・領収書など)」にサンプルを読み込ませ、標準機能での抽出精度を確認する
- 標準モデルで抽出できない独自項目がある場合は、最低5枚のサンプル文書に画面上でラベル付け(アノテーション)を行い、「カスタム抽出モデル」をトレーニングして精度を測定する
検証時は、単に文字が正しくテキスト化されているかだけでなく、抽出された各項目に対してAIが出力する「信頼度スコア(Confidence Score)」を確認します。業務上許容できる認識精度の基準をあらかじめ定めておき、どのモデルを採用すべきか、また前処理(画像の傾き補正や解像度の変更など)が必要かを判断します。
運用フローの構築とカスタムモデルの継続的な学習
PoCで十分な読み取り精度が確認できたら、本番環境の構築と業務フローへの組み込みを行います。AI-OCRの認識精度は帳票の品質によって変わり、かすれ文字や未知のレイアウトでは誤認識が発生する可能性があります。そのため、データの正確性が求められる業務では、AIの抽出結果を人間が確認・修正する「Human in the Loop(人間が介在するプロセス)」を前提とした運用フローを設計します。
効率的な運用フローを構築するには、APIから返却される信頼度スコアの活用が有効です。たとえば、信頼度スコアが一定のしきい値(例:90%以上。公式に推奨しきい値は示されていないため、PoCで自社の基準を決めます)を超えた項目は後続の業務システムへ自動連携し、しきい値を下回った不確実な項目のみを管理画面にハイライト表示して担当者が目視確認するといった振り分けルールを設定します。これにより、全件を目視確認する手間を省きつつ、誤データの登録を防ぐことができます。
また、運用開始後に新規の取引先が増えたり、既存の帳票レイアウトが変更されたりすると、読み取り精度が低下することがあります。このような変化に対応するため、本番運用で読み取りに失敗した帳票データを蓄積し、カスタムモデルへ追加学習(再トレーニング)させる体制を整えておくことが重要です。さらに、複数の異なるフォーマットの帳票を1つのエンドポイントで処理したい場合は、複合モデル(Composed Model)機能を使い、最大500個のカスタムモデルを1つのモデルIDにまとめられます。API 2024-11-30(GA)では、先に分類モデル(Classifier)をトレーニングして文書の種類を振り分ける方式になり、信頼度に基づくルーティングも設定できます。
よくある質問(FAQ)
Azure Document Intelligenceの料金体系はどのようになっていますか?
Azure Document Intelligenceの料金は、処理したページ数に応じた従量課金制(Pay-As-You-Go)が基本で、公式の価格ページでは1,000ページ単位で掲載されています。モデルの種別によって課金の区分が分かれています。また、月間の処理量が見込める場合は、容量を事前に確保する「コミットメントティア」が選べる場合があります。Microsoftのコンテナ文書では、コミットメントティアは標準料金より割引された料金で提供されると説明されています。適用条件は価格ページで確認してください。
公式の価格ページに掲載されている課金区分は以下の通りです(確認できた時点のページには金額が表示されていなかったため、単価の高低は記載していません)。
| モデルカテゴリ | 主な対象機能・モデル | 価格ページ上の課金区分 |
|---|---|---|
| 読み取り(Read) | 読み取り(Read)モデル | 独立した区分で、処理量に応じた段階課金(0〜100万ページ、100万ページ超) |
| 事前構築済みモデル(Prebuilt) | レイアウト、領収書、請求書、IDドキュメントなど | 「All Prebuilt Models」として、レイアウトを含む1つの区分 |
| カスタムモデル(Custom) | カスタム分類、カスタム抽出、カスタム生成AI抽出 | それぞれ別の区分。トレーニングは「1時間あたり」の区分あり |
| アドオン機能 | 高解像度処理、フォント・スタイル抽出、数式抽出、バーコード、キーバリューペアなど | 追加課金の区分あり |
カスタムモデルのトレーニングについては、価格ページに「トレーニング1時間あたり」の課金区分があります。テンプレート型が無料か、ニューラル型に無料枠があるかは、確認できた公式情報では判断できませんでした。なお公式のカスタムモデル解説では、ニューラルモデルの既定のトレーニング時間は30分で、それより長く学習させる場合は有料トレーニングを有効にする必要があるとされています。最新の単価や無料枠は、Microsoft公式のAzure AI Document Intelligence の価格ページと価格計算ツールで確認してください。
無料の試用版(Freeティア)ではどこまで検証できますか?
Azureアカウントを作成し、リソース作成時に価格レベルとして「Free(F0)」を選択すると、毎月500ページまで無料で検証できます(公式価格ページの「Free - Web/Container」)。無料枠で利用できるモデルの範囲は、確認できた公式ページでは明記がなかったため、検証したいモデルが使えるかはリソース作成時に確認してください。
ただし、Freeティアには本番運用と区別するための制限が設けられています。検証時に注意すべき主な制約は以下の通りです。
- 月間の無料枠は500ページまで(超過後の扱いは公式で要確認。必要に応じてS0へ切り替えます)
- アップロードできる1ファイルあたりのサイズ上限は4MBまで(S0ティアでは500MBまで)
- 1回のリクエストで解析されるのは先頭2ページまで(S0は最大2,000ページ)
- 1秒あたりの解析トランザクション数の上限は、F0が1、S0の既定が15(F0の上限は調整不可)
3ページ以上にわたる複数ページの契約書や、高解像度でファイルサイズが4MBを超えるスキャン画像を検証したい場合は、一時的に価格レベルを「Standard(S0)」に切り替えることでこれらの制限が緩和されます(S0でも1ファイル500MB・2,000ページが上限です)。
日本語の縦書き文書や印鑑が重なった文字も読み取れますか?
縦書きや、印影(朱肉)が重なった文字に対する対応の可否・精度は、確認できた公式ドキュメント(Read、レイアウト、IDドキュメント)に明確な記載が見当たりませんでした。そのため、「高い精度で読み取れる」とは断定できません。縦書きと横書きが混在する文書や、押印が文字に重なる書類は、実際の帳票サンプルでDocument Intelligence Studioを使って検証してください。
精度が足りない場合は、同様のサンプルを含めてカスタムモデル(ニューラル型など)の学習を試す選択肢があります。ただし、効果は書類によって異なるため、検証が前提です。画質の目安として、公式ドキュメントでは、文字の高さが1024×768ピクセルの画像で12ピクセル以上(150dpiで約8ポイント相当)とされています。
入力した機密文書データがAIの学習に流用されることはありませんか?
結論から言うと、確認できたMicrosoft Learnのデータ・プライバシー・セキュリティのページには、送信した文書データを基盤モデルの学習に使うかどうかの記述は見つかりませんでした(詳細はMicrosoft Trust Centerで確認するよう案内されています)。そのため本記事では「学習に使われない」と断定しません。契約条件や公式のデータ利用方針で確認することをおすすめします。公式ページで確認できたデータの取り扱い仕様は次の通りです。
- 送信された入力データと解析結果は、解析完了後24時間保存され、その後自動的に削除される(Delete Analyze Result APIで早期に削除することも可能)
- カスタムモデルのトレーニング用データは顧客自身のAzure Blobストレージに置かれ、学習中の中間出力も同じ場所に保存される。学習済みのカスタムモデルは同一リージョンのAzureストレージに、サブスクリプションとAPI資格情報で論理的に分離して保存される
- 通信はHTTPSで暗号化される(クライアントOSがTLS 1.3に対応している必要がある)
- 保存データは既定でMicrosoft管理キーで暗号化され、顧客管理キー(CMK)も利用できる(キーの保管にはAzure Key Vaultが必要)
- 入力データは、Document Intelligenceリソースを作成したリージョンで処理される
金融機関や医療機関、官公庁の要件に適合するかどうかは、各組織の規程と公式のコンプライアンス資料で個別に確認してください。詳細なデータ保護ポリシーについては、公式ドキュメントのDocument Intelligence のデータ、プライバシー、セキュリティを参照してください。
オンプレミス環境(インターネット非接続)でも利用できますか?
Azure Document Intelligenceは、Dockerコンテナとして提供される「コンテナサポート」機能を利用することで、オンプレミス環境や閉域網でもOCRおよび文書解析を実行できます。機密文書を社内ネットワーク(オンプレミスサーバーやプライベートクラウド)から外部に出せないセキュリティポリシーを持つ企業に適した構成です。
コンテナ版を導入する際の主な仕様と条件は以下の通りです。
- 提供されるモデルはコンテナのバージョンによって異なる。v4.0コンテナはRead・Layout、v3.1コンテナはRead・Layout・IDドキュメント・領収書・請求書、v3.0コンテナはRead・Layout・一般ドキュメント・名刺・カスタムモデル
- 解析対象となる文書データ自体はインターネットを経由せず、すべてローカルのコンテナ環境内で処理が完結する
- コンテナは課金情報をAzureへ送るため、通常は常にAzureへ接続できる必要がある。接続できない状態が続くと、10〜15分間隔で10回再試行した後、リクエストの処理を停止する(解析対象のデータ自体はMicrosoftに送信されない)
- 完全に切断された環境で運用する場合は、申請フォームの提出とコミットメントプランの購入(価格レベル「Commitment tier disconnected containers DC0」)が必要となる
コンテナを稼働させるためには、モデルのサイズに応じたCPUコア数やメモリ容量を備えたホストサーバーを自社で用意する必要があります。
まとめ
本記事では、Azure Document Intelligenceを活用して業務を効率化するための要点を解説しました。
- 非定型帳票からテキストと表構造を抽出できる(手書きの対応言語は要確認)
- 請求書などの帳票処理を自動化し、担当者の入力工数の削減が期待できる
- API連携により既存システムやAzure OpenAI Serviceへデータを引き渡せる
- 導入時は対象業務の投資対効果を試算し、Document Intelligence Studioで精度を検証する
まずは無料枠(Freeティア)を利用し、自社の帳票データを使った読み取り精度の検証を実践してみましょう。