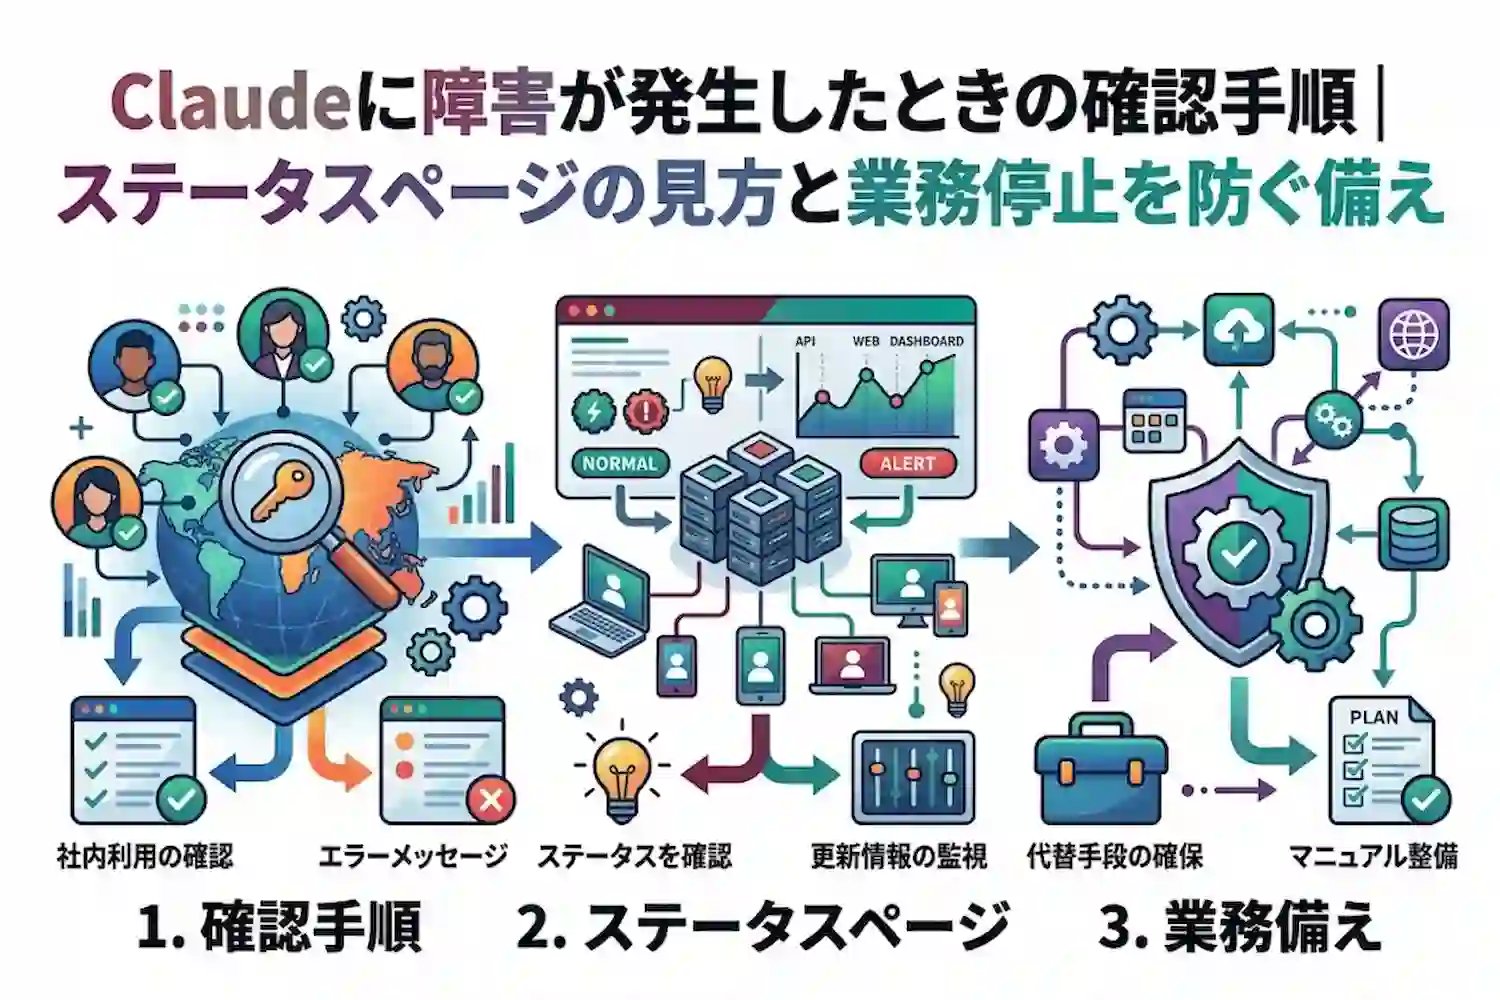
Claudeが使えないときは、まずステータスページで障害の有無を確認し、問題がなければ自分側の環境や利用上限を順に切り分けます。過去には、複数の製品に同時に影響する障害も起きています。本記事では、確認手順、エラーの読み方、業務を止めないための備えを整理します。
この記事で分かること
- Claudeに障害が起きたときに最初に確認する場所
- 障害か自分側の問題かを切り分ける5つのステップ
- 529などエラー表示の意味と、利用上限との違い
- 過去の障害事例から分かる傾向
- 業務停止を防ぐために、情シスが準備しておくこと
Claudeが使えないときは、まずステータスページを確認する
障害かどうかを最短で判断する方法は、公式のステータスページを見ることです。サービス全体の障害であれば、自分側の設定を調べても解決しないため、最初の確認で時間を節約できます。
ステータスページでわかること
Anthropicのステータスページ(status.claude.com)では、サービスごとの状態と、障害の経過が公開されます。ステータスページには、claude.ai、Claude Console(platform.claude.com)、Claude API(api.anthropic.com)、Claude Code、Claude Cowork、Claude for Governmentの6つのコンポーネントが並び、障害のたびに影響を受けた対象が示されます。
対象の製品を見分ける
自分が使っている製品が、影響を受けているかを確認します。たとえば、Webのチャットは使えるのに、Claude Codeだけ使えない、あるいはAPI経由のシステムだけが止まる、といったケースがあります。障害の報告では、影響を受けた対象が項目ごとに示されます。
状況は更新されていく
障害の報告は、調査中、原因の特定、監視中、解決済みの順に更新されます。たとえば、2026年4月28日の障害では、claude.aiへアクセスできない問題が発生し、API側にも認証エラーが生じました。その後、原因を特定し、監視を経て、解決が報告されています。
障害か自分側の問題かを切り分ける5ステップ
ステータスページに障害の記載がなければ、自分側の要因を、影響の大きい順に確認します。次の5つのステップで進めると、無駄な作業を避けられます。
STEP1:ステータスページで障害の有無を確認する
status.claude.comを開き、進行中の障害や、性能の低下がないかを確認します。障害が出ているなら、復旧を待つのが基本です。
STEP2:利用上限に達していないか確認する
応答が止まる原因が、障害ではなく利用上限の場合があります。公式ヘルプでも、音声モードで応答が止まる場合は、利用上限に達していないかを確認するよう案内されています。メッセージ入力欄の付近に、利用状況の表示が出ていないかを見てください。
STEP3:ブラウザやアプリを変えて試す
別のブラウザや、シークレットウィンドウで、claude.aiを開き直します。拡張機能やキャッシュが影響している場合は、これで解消することがあります。モバイルなら、アプリの再起動も試します。
STEP4:ネットワーク環境を確認する
社内ネットワークでは、ファイアウォールやプロキシが、通信を遮断している場合があります。自宅のWi-Fiやモバイル回線など、別の経路で試すと、原因の切り分けが進みます。
STEP5:コネクタや連携の設定を見直す
連携しているサービスで、問題が起きているケースもあります。公式ヘルプでは、認証に失敗する場合は、いったん解除して接続し直す、接続先のアカウントが有効か確認する、といった手順が案内されています。
表示されるエラーの意味
エラーの種類で、原因の見当がつきます。ただし、メッセージの表記はアプリや環境で異なるため、あくまで目安として扱ってください。
| 症状・表示 | 考えられる原因 | 対応の目安 |
|---|---|---|
| 529 Overloaded(過負荷) | 需要の集中など、Anthropic側の混雑 | しばらく待ってから再試行する |
| Internal Server Error(500系) | サーバー側の一時的な問題 | ステータスページを確認し、時間をおく(APIでは、間隔を空けて再試行し、続く場合はリクエストIDを添えてサポートへ連絡) |
| 利用上限の表示 | プランの上限に達した | 上限の解除を待つか、プランや設定を見直す |
| ログインできない・認証エラー | 認証基盤の障害、またはアカウントの問題 | ステータスページを確認し、再ログインを試す |
| 接続のタイムアウト(カスタムコネクタ) | サーバーが公開インターネットから届かない | ネットワーク要件を確認する |
529は、混雑を示す表示
公式のAPIエラー一覧では、529(overloaded_error)は「APIが一時的に過負荷」の状態で、全ユーザーにまたがる高いトラフィックで起こりうると説明されています。自分のアカウントの利用上限とは別の話です。一方、2026年8月24日の障害の報告には、原因は「特定して解決した」とあるだけで、過負荷が根本原因だとは書かれていません。表示だけで、原因を断定しないようにしましょう。
利用上限は、障害とは別物
利用上限に達した場合は、サービスの不具合ではなく、プランの制限による表示です。待ち時間が過ぎれば解消するため、再試行しても変わらない場合は、上限の状況を確認してください。
過去の障害事例から見えること
過去の事例からは、複数の製品が同時に影響を受けること、認証系の問題が業務に直結することが分かります。
- 2026年4月28日:claude.aiへのアクセス不能と、APIやClaude Codeへの認証エラーが発生。影響は、協定世界時(UTC)の17時34分から18時52分で、日本時間では4月29日の午前2時34分から3時52分にあたる
- 2026年8月24日:Mythos 5、Fable 5、Opus 5、Opus 4.8など複数のモデルでエラーが増え、claude.aiとClaude APIに影響。エラーが続いたのは協定世界時(UTC)の4時50分から7時36分で、日本時間では13時50分から16時36分にあたる
4月の障害は、チャット、API、開発ツールにまたがりました。8月の障害も、チャットとAPIの両方に及んでいます。ひとつの製品だけを前提にした備えでは足りない点に注意が必要です。
業務停止を防ぐための備え
障害は避けられないため、起きたときの動きを事前に決めておくことが、最大の備えです。特に、Claudeを業務の流れに組み込んでいる場合は、代替手段まで設計しておきます。
1. 情報の入り口を一本化しておく
障害時の問い合わせが分散しないよう、まず確認する場所を社内で決めておきます。ステータスページを確認する担当、利用者への連絡手段、復旧の見通しを伝える窓口を明確にします。
2. 手作業の代替手順を用意する
重要な業務ほど、Claudeが使えない場合の代替手順を決めておきます。たとえば、定型の文書作成は、テンプレートから人が作成する、問い合わせ対応は、既存のFAQで対応する、といった形です。
3. 重要な成果物はこまめに保存する
作業中の成果物は、Claudeの画面上だけに置かず、ローカルや社内の保管場所にも保存します。障害で画面が止まっても、作業内容を失わずに済みます。
4. API利用なら複数の提供経路を検討する
システムからClaudeのAPIを利用している場合、提供経路の選択肢があります。ClaudeのモデルはClaude APIのほか、Amazon Bedrock、Google Cloud、Microsoft Foundryでも利用できると、公式ドキュメントに記載されています(提供状況はモデルによって異なります)。経路を分散できるか、設計の段階で確認しておきましょう。なお、公式SDKは、接続エラー、レート制限、5xxエラーを、間隔を空けながら標準で2回まで自動的に再試行します(回数は設定で変えられます)。
5. 利用者向けの周知を準備する
障害時の対応方針を、短い文書にして周知しておきます。慌てて、再ログインや再インストールを繰り返し、状況を悪化させることを防げます。
情シスが運用に組み込みたい項目
運用では、検知、連絡、記録の3点を整えると、対応が安定します。
- ステータスページの確認を、障害対応の初動に位置づける
- 利用部門への連絡テンプレートを用意する
- 障害の発生時刻、影響した業務、対応内容を記録する
- 重要業務のClaude依存度を、定期的に棚卸しする
障害時の社内連絡の考え方
障害時の連絡は、速さと一貫性が大切です。現場が自己判断で動くと、再ログインの繰り返しや、重複した問い合わせが起き、混乱が広がります。
連絡に含めたい項目
連絡文には、次の項目を入れておくと、受け取った人が次の行動を判断できます。
- 確認した時刻と、確認した場所(公式ステータスページなど)
- 影響を受けている製品(チャット、API、Claude Codeなど)
- 利用者にお願いしたい行動(待機、代替手順への切り替えなど)
- 次の更新予定の時刻
分かっていないことは、分からないと伝える
復旧の見通しが不明なら、不明であると伝えます。根拠のない見通しを伝えると、後で訂正が必要になり、信頼を損ねます。公式の報告が更新されたら、連絡も更新しましょう。
障害後の振り返りで備えを強くする
障害が収まった後に記録を見直すと、次回の対応が速くなります。振り返りは、責任追及ではなく、仕組みの改善を目的に行います。
記録しておきたい内容
発生時刻、影響した業務、気づいた経路、取った対応、復旧の確認方法を、簡潔に残します。公式の障害報告と、社内の記録を並べると、対応の遅れた箇所が見えます。
見直しの観点
- 気づくまでに時間がかかっていないか
- 代替手順は、実際に使えたか
- 連絡先や担当が、最新か
- Claudeに依存しすぎている業務はないか
定期的な訓練も有効
代替手順は、使ってみないと不備に気づけません。重要な業務については、Claudeが使えない想定で、手作業の手順を試す機会を設けると、実際の障害時にも落ち着いて動けます。
Claudeに依存する業務を棚卸しする進め方
備えの第一歩は、どの業務がClaudeに依存しているかを、把握することです。把握できていないと、障害時に何が止まるのかを判断できません。
STEP1:利用している業務を書き出す
各部門に、Claudeを使っている業務を挙げてもらいます。チャットでの文書作成、API連携のシステム、Claude Codeでの開発など、製品ごとに整理します。
STEP2:止まったときの影響を評価する
業務ごとに、止まった場合の影響の大きさと、許容できる停止時間を確認します。影響が大きい業務から、代替手順を整えます。
STEP3:代替手順と担当を決める
影響の大きい業務について、手作業での代替手順と、切り替えの判断をする担当を決めます。決めた内容は、短い文書にして周知します。
よくある質問(FAQ)
Claudeが応答しないときは、最初に何を確認すればよいですか?
最初に、ステータスページ(status.claude.com)で障害の有無を確認します。障害がなければ、利用上限、別のブラウザでの動作、ネットワークの順に切り分けます。
Claudeの障害情報はどこで確認できますか?
Anthropicの公式ステータスページで確認できます。サービスごとの状態と、障害の経過が公開されます。第三者の監視サービスもありますが、公式の情報を基準にしてください。
529エラーとは何ですか?
サービスが過負荷の状態にあることを示すエラーとして知られています。多くは、Anthropic側の混雑が原因で、しばらくして再試行すると解消します。ただし、表示だけで原因を断定することは避けてください。
利用上限に達した場合と障害の違いは何ですか?
利用上限は、プランの制限による表示で、サービスの不具合ではありません。障害は、サービス側の問題で、多くのユーザーに同時に影響します。ステータスページに記載があるかどうかが、判断の目安です。
障害に備えて企業が準備しておくことはありますか?
代替手順の用意、成果物の保存、連絡体制の整備が基本です。API利用なら、複数の提供経路の検討も有効です。重要業務のClaudeへの依存度を、定期的に見直しましょう。
Claudeの障害対応を整えるためのまとめと次の一歩
Claudeが使えないときは、ステータスページの確認から始め、利用上限、ブラウザ、ネットワーク、連携の順に切り分けます。障害は複数の製品に及ぶことがあるため、業務を止めない備えが欠かせません。
- 最初の確認は、公式ステータスページの障害情報
- 利用上限の表示は、障害とは別物として切り分ける
- 529などの表示は目安で、表示だけで原因を断定しない
- 障害は、チャットとAPI、開発ツールに同時に影響することがある
- 代替手順、成果物の保存、連絡体制を事前に整える
まずは、自社でClaudeを使っている業務を書き出し、止まったときの代替手順を一つずつ決めてみましょう。備えがあれば、障害が起きても落ち着いて対応でき、業務への影響を最小限に抑えられます。備えは一度整えて終わりではなく、利用の広がりに合わせて見直すものです。定期的に棚卸しを行い、代替手順や連絡体制を更新していけば、障害への強さが少しずつ高まっていきます。あわせて、障害時の連絡先も周知しておくと安心です。