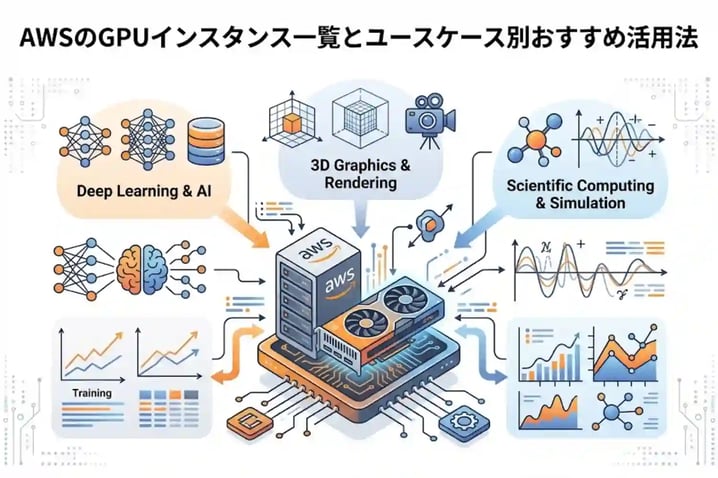
この記事で分かること
- AWS GPUインスタンス(Pシリーズ・Gシリーズ)の違いと選び方
- 生成AI開発や画像処理など、目的別の最適なインスタンス
- GPU環境構築時のAMI選定やクォータ引き上げの手順
AWSのGPUインスタンスは、機械学習に特化したPシリーズと、グラフィックス処理や推論に優れたGシリーズに大別されます。生成AIの学習や大規模なディープラーニングには、A100搭載のP4d、H100搭載のP5、Blackwell世代のP6などのPシリーズが候補になり、動画配信やコストを抑えた推論にはG5やG4dn、より新しいG6やG6eなどが選択肢になります。本記事では、各インスタンスのスペック比較やユースケース別の推奨モデル、環境構築に必要なAMIの選び方やクォータ引き上げの手順まで、AWSでGPUを導入・運用するための具体的な判断基準を提示します。
AWS GPUインスタンスの基礎知識
AWS(Amazon Web Services)では、膨大な計算リソースを必要とするワークロード向けに、GPUを搭載したEC2インスタンスを提供しています。ここでは、オンプレミスではなくクラウド環境でGPUを利用する利点と、AWSが提供するGPUインスタンスファミリーの全体像を解説します。
なぜクラウドでGPUが必要なのか
近年、生成AIの開発やディープラーニングモデルのトレーニング、自動運転のシミュレーションなど、高度な並列処理能力を必要とするプロジェクトが急増しています。これらの処理をCPUのみで実行するには時間がかかりすぎるため、並列演算に特化したGPU(Graphics Processing Unit)が不可欠です。
しかし、高性能なGPUサーバーを自社で構築・運用する場合、ハードウェアの調達コストや納期の遅延、さらには電力や冷却設備などの維持管理費が大きな負担となります。そこで、初期費用なしで必要な時に必要な分だけ計算リソースを確保できるクラウドGPUの活用が主流となっています。
- 最新の高性能GPUをハードウェアの納品を待たずに即座に利用開始できる
- プロジェクトの規模に応じてインスタンス数やスペックを柔軟にスケールアップ・ダウンできる
- 利用した時間分だけの従量課金制により、アイドル時の無駄なコストを削減できる
このように、インフラの調達や保守管理から解放され、開発やデータ分析そのものに集中できることが、AWSをはじめとするクラウド環境でGPUを利用する最大の理由です。
AWS EC2におけるGPUファミリーの概要
AWSの仮想サーバーサービスであるAmazon EC2では、用途や要件に応じて最適化された複数のGPUインスタンスファミリーが用意されています。大きく分けると、機械学習のトレーニングやHPC(ハイパフォーマンスコンピューティング)に特化した「Pシリーズ」と、グラフィックス処理や機械学習の推論コストに優れた「Gシリーズ」の2種類が主流です。
各インスタンスファミリーの主な特徴と想定されるワークロードは以下の通りです。各インスタンスの詳細なスペックや具体的な選び方については、次章以降で解説します。
| インスタンスファミリー | 主な搭載GPU | 得意とする主な用途 | 特徴 |
|---|---|---|---|
| Pシリーズ(P4, P5など) | NVIDIA V100(P3)、A100(P4d/P4de)、H100(P5)、H200(P5e/P5en)、B200/B300(P6) | 大規模言語モデル(LLM)の学習、複雑なディープラーニング、HPC | 高いネットワーク帯域と演算性能を備え、分散学習などの大規模処理に向いている。 |
| Gシリーズ(G4, G5など) | NVIDIA T4(G4dn)、A10G(G5)、L4(G6)、L40S(G6e)など | 機械学習の推論、3Dレンダリング、動画エンコーディング、仮想ワークステーション | Pシリーズと比較してコストパフォーマンスが高く、グラフィックス処理やリアルタイム推論に適している。 |
| Trn / Infシリーズ(※補足) | AWS Trainium, Inferentia | 機械学習の学習・推論(コスト最適化) | NVIDIA製GPUではなく、AWSが独自設計した機械学習専用のアクセラレータ。特定のフレームワークで高いコスト効率を発揮する。 |
AWSでは、NVIDIAとの継続的な協業により最新アーキテクチャのGPUをいち早く導入しています。Amazon EC2 インスタンスタイプのラインナップには、世代が新しくなるごとに処理性能やメモリ帯域が大幅に向上したモデルが追加されており、要件に合わせて費用対効果の高い環境を選択することが可能です。
主要なAWS GPUインスタンス一覧と比較
AWSのAmazon EC2で提供されているGPUインスタンスは、用途に応じて複数のファミリーに分類されています。ここでは、機械学習やディープラーニングのトレーニングに特化した「Pシリーズ」と、グラフィックス処理や機械学習の推論コストパフォーマンスに優れた「Gシリーズ」の主要なインスタンスを比較します。
| インスタンスファミリー | 搭載GPU | 主な用途 | 特徴 |
|---|---|---|---|
| P4d | NVIDIA A100 | 大規模言語モデル(LLM)の学習、複雑なディープラーニング | A100搭載の学習向け。広帯域ネットワーク |
| P3 | NVIDIA V100 | 一般的な機械学習の学習・推論、HPC | V100搭載の旧世代の学習用インスタンス(AWSは現行世代の利用を推奨) |
| G5 | NVIDIA A10G | グラフィックスレンダリング、生成AIの推論・ファインチューニング | 高いグラフィックス性能と推論のコストパフォーマンス |
| G4dn | NVIDIA T4 | 小規模な推論、クラウドゲーミング、動画エンコード | T4搭載で、導入しやすいGPUインスタンス |
より新しい世代のGPUインスタンス
AWSのEC2公式仕様表(2026年10月時点で確認)には、上の4種類以外にも新しい世代のGPUインスタンスが掲載されています。下の表は、各ファミリーの最大サイズの値です。
| インスタンスファミリー | 搭載GPU | GPUメモリ(最大サイズ) | ネットワーク(最大サイズ) |
|---|---|---|---|
| P5 | NVIDIA H100 × 8 | 640 GiB(8 × 80 GiB) | 3200 Gigabit |
| P5e / P5en | NVIDIA H200 × 8 | 1128 GiB(8 × 141 GiB) | 3200 Gigabit |
| P6-B200 | NVIDIA B200 × 8 | 1432 GiB(8 × 179 GiB) | 3200 Gigabit |
| G6 | NVIDIA L4 × 8 | 178 GiB(8 × 22 GiB) | 100 Gigabit |
| G6e | NVIDIA L40S × 8 | 357 GiB(8 × 44 GiB) | 400 Gigabit |
| G7e | NVIDIA RTX PRO Server 6000 × 8 | 768 GiB(8 × 96 GiB) | 1600 Gigabit |
このほか、P4de(A100 80GB × 8)やP6-B300(B300)などもあります。提供状況はリージョンによって異なるため、利用前にAWSの公式ページで確認してください。
ディープラーニング特化のPシリーズ
Pシリーズは、膨大な計算リソースを必要とするディープラーニングのモデルトレーニングやハイパフォーマンスコンピューティング(HPC)向けに設計されています。複数世代のインスタンスが提供されており、要件に合わせて選択できます。
P4dインスタンスのスペックと用途
P4dインスタンスは、NVIDIA A100 Tensor Core GPUを搭載し、前世代のP3インスタンスと比較して機械学習モデルのトレーニング時間を大幅に短縮します。最大400Gbpsのネットワーク帯域幅を備えたElastic Fabric Adapter(EFA)とNVIDIA GPUDirect RDMAをサポートしており、マルチノードでの分散学習において高いスケーラビリティを発揮します。
- 搭載GPU: NVIDIA A100 Tensor Core(最大8基)
- GPUメモリ: 1基あたり40GB(p4d.24xlargeで合計320GB)
- ネットワーク: 最大400Gbps
主に、大規模言語モデル(LLM)のトレーニングや、自動運転向けの複雑な画像認識モデルの構築などに利用されます。A100のメモリを80GBに増やしたP4deもあります。
P3インスタンスのスペックと用途
P3インスタンスは、NVIDIA V100 Tensor Core GPUを搭載したディープラーニング向けインスタンスです。AWSのドキュメントでは旧世代(previous generation)に分類されており、AWSは最適な性能のために現行世代のインスタンスタイプの利用を推奨しています。既存の環境で、一般的な機械学習モデルのトレーニングに使われてきました。
- 搭載GPU: NVIDIA V100 Tensor Core(最大8基)
- GPUメモリ: 1基あたり16GBまたは32GB(p3dn.24xlarge)
- ネットワーク: 最大100Gbps
自然言語処理、音声認識、画像分類などの標準的なAIモデルの開発や、金融モデリング、流体力学などのHPCワークロードに適しています。新規に環境を構築する場合は、Amazon EC2 インスタンスタイプの現行世代から選ぶことをおすすめします。
グラフィックス処理に強いGシリーズ
Gシリーズは、3Dレンダリングやクラウドゲーミングなどのグラフィックスワークロードに加え、機械学習モデルの推論をコスト効率良く実行するために設計されています。
G5インスタンスのスペックと用途
G5インスタンスは、NVIDIA A10G Tensor Core GPUを搭載しています。AWSの発表では、G4dnと比較して、グラフィックス処理で最大3倍、機械学習の推論で最大3倍のパフォーマンスを提供するとされています。
- 搭載GPU: NVIDIA A10G Tensor Core(最大8基)
- GPUメモリ: 1基あたり24GB
- ネットワーク: 最大100Gbps
リアルタイムのレイトレーシングを伴う仮想ワークステーションの構築や、高解像度の動画エンコーディングに最適です。また、GPUメモリが24GBあるため、生成AIモデルの推論や小規模なファインチューニングを低コストで実行したい場合にも有力な選択肢となります。
G4dnインスタンスのスペックと用途
G4dnインスタンスは、NVIDIA T4 Tensor Core GPUを搭載した、導入しやすいGPUインスタンスです。
- 搭載GPU: NVIDIA T4 Tensor Core(最大8基)
- GPUメモリ: 1基あたり16GB
- ネットワーク: 最大100Gbps
画像分類やオブジェクト検出といった小規模な機械学習モデルの推論、クラウドゲーミング、仮想デスクトップ(VDI)環境の構築に広く利用されます。学習済みのAIモデルを本番環境で稼働させる際のインフラコストを抑えたい場合の候補になります。
目的別おすすめのAWS GPU活用法
AWSのGPUインスタンスは、用途に応じて適切なファミリーやサイズを選択することで、コストを抑えつつ高いパフォーマンスを引き出すことができます。ここでは、代表的な4つのユースケースにおける最適なインスタンスの選び方と活用方法を解説します。
生成AIの開発とトレーニング
大規模言語モデル(LLM)や画像生成AIの開発には、膨大なパラメーターの計算と大容量のGPUメモリが必要です。数千億パラメーター規模のモデルをゼロから学習させる場合、NVIDIA A100を搭載したP4dインスタンスや、H100を搭載したP5、H200を搭載したP5e/P5en、B200を搭載したP6などのPシリーズが候補になります。これらはノード間の高速なネットワーク帯域を備えており、複数インスタンスを用いた分散学習の通信ボトルネックを解消します。
一方で、既存のオープンソースモデルを特定の業務向けに微調整するファインチューニングや、開発したモデルの推論環境の構築には、コストパフォーマンスに優れたG5インスタンスが推奨されます。学習フェーズと推論フェーズでインスタンスファミリーを分割することで、不要なコンピューティングコストを削減できます。
| フェーズ | 推奨インスタンス | 選定の理由 |
|---|---|---|
| 大規模モデルの事前学習 | P4d, P5, P6など | 大容量メモリと高速なGPU間通信(NVLink/EFA)が必須となるため |
| ファインチューニング | G5(規模が大きい場合はP4dなど) | 中規模の計算リソースで十分であり、コストを最適化しやすいため |
| モデルの推論・デプロイ | G5, G4dn | 単精度・半精度の演算性能が高く、応答速度とコストのバランスが良い |
自動運転シミュレーション
自動運転システムの開発では、車載カメラやLiDARから得られる膨大なセンサーデータを処理し、仮想空間上で数百万キロメートルに及ぶ走行シミュレーションを行う必要があります。このような物理演算とディープラーニングを並行して実行するワークロードでは、GPUの演算能力だけでなく、CPUとメモリのバランスも重要です。
シミュレーション環境のレンダリングや強化学習の実行には、グラフィックス処理と機械学習の両方で高い性能を発揮するG5インスタンスが適しています。複数のシミュレーションを並列で実行する場合は、コンテナオーケストレーションサービス(Amazon EKSなど)と組み合わせてGPUリソースを動的にスケーリングさせる構成が一般的です。
動画エンコーディングと配信
ライブストリーミングやオンデマンド動画の配信プラットフォームでは、高画質な映像を複数の解像度やビットレートへリアルタイムに変換(トランスコード)する処理が求められます。NVIDIA T4 GPUを搭載したG4dnインスタンスは、GPUのハードウェアエンコーダー(NVENC)を利用して動画のエンコードを行えます。
- H.264やHEVC(H.265)などの高圧縮フォーマットへのリアルタイム変換
- 映像内のオブジェクト検知や自動字幕生成など、AI処理の同時実行
- 複数ストリームの同時エンコードによるインフラコストの削減
動画処理に特化する場合は、GPUの演算コア(CUDAコア)よりもハードウェアエンコーダーの性能と数がスループットに影響します。そのため、上位のPシリーズを選択するよりも、G4dnやG5インスタンスを複数台並列稼働させるスケールアウト型のアプローチが適しています。詳しくはAWSのEC2インスタンスタイプ一覧で各インスタンスのネットワーク帯域幅を確認し、配信規模に応じたサイジングを行ってください。
仮想ワークステーションとしての利用
3D CAD、BIM、ハイエンドな映像編集などのグラフィックス集約型タスクをクラウド上で実行する場合、AWSのGPUインスタンスを仮想ワークステーションとして利用できます。手元の端末のスペックに依存せず、セキュアな環境で大容量のデータを直接編集できるのが利点です。
この用途では、NVIDIA RTX Virtual Workstation(vWS)ライセンスがバンドルされたG4dnまたはG5インスタンスのAMI(Amazon Machine Image)を使用します。これにより、物理的なワークステーションと同等の描画性能とドライバサポートをクラウド上で得ることができます。
- AWS Marketplaceから「NVIDIA RTX Virtual Workstation」対応のAMIを選択する
- 必要なvCPU、メモリ、GPUスペックに応じてG4dnまたはG5インスタンスを起動する
- NICE DCVなどの高性能なリモートデスクトッププロトコルを使用して接続する
高解像度のマルチモニター環境や、色再現性が求められるプロフェッショナルなクリエイティブ作業においても、クラウド側のGPUでレンダリングを完結させ、画面の差分データのみを転送することで遅延のない操作性を実現します。
AWS GPU環境の構築と運用のポイント
AWSのGPUインスタンスを導入する際、ハードウェアのスペック選びと同様に重要なのが、ソフトウェア環境の構築と周辺リソースの最適化です。GPUの計算能力を最大限に引き出すための設定方法を解説します。
最適なAMIの選び方
GPUインスタンスを起動する際、OSのみの標準AMIを選択すると、NVIDIAドライバやCUDAツールキット、cuDNNなどのライブラリ群を自力でインストールする必要があります。バージョン間の依存関係が複雑なため、用途に合わせて事前設定された最適化済みAMIを利用することで、環境構築の工数を大幅に削減できます。
AWS環境でGPUを利用する際によく使われる代表的なAMIは以下の通りです。
| AMIの種類 | 主な用途と特徴 |
|---|---|
| AWS Deep Learning AMI (DLAMI) | TensorFlowやPyTorchなどの主要なフレームワークと、GPUドライバが事前インストールされたAMIです。機械学習の学習や推論環境を即座に立ち上げたい場合に適しています。 |
| NVIDIA GPU-Optimized AMI | NVIDIAが公式に提供しており、最新のドライバとコンテナ実行環境(NVIDIA Docker)がセットアップされています。独自のコンテナイメージを持ち込んで運用する際に便利です。 |
| Amazon ECS-optimized Amazon Linux 2023 GPU AMI | Amazon ECSでGPUワークロードを実行するためのAMIです。NVIDIAカーネルドライバとDocker GPUランタイムがあらかじめ設定されています。AWSの公式ドキュメントによると、Amazon Linux 2のECS最適化AMIは2026年6月30日にサポートが終了しているため、Amazon Linux 2023ベースのAMIを選択してください。 |
特に機械学習の用途では、AWSが提供するAWS Deep Learning AMIを選択するのが一般的です。利用するフレームワークのバージョン要件に合わせて、適切なAMIを選択してください。
ストレージとネットワークの最適化
高性能なGPUインスタンスを使用しても、データの読み込みやインスタンス間の通信に時間がかかると、GPUが待機状態(アイドル)になり、コストパフォーマンスが低下します。
ストレージのボトルネックを解消するためには、以下の構成を検討します。
- Amazon EBSのボリュームタイプを汎用SSD(gp3)から、プロビジョンドIOPS SSD(io2)に変更し、I/O性能を確保する
- 大規模なデータセットを扱う機械学習の学習フェーズでは、一時領域としてインスタンスストア(NVMe SSD)を活用する
- 複数のインスタンスから同時に高速なファイルアクセスが必要な場合は、Amazon FSx for Lustreを導入する
また、複数台のGPUインスタンスを連携させる分散学習やHPC(ハイパフォーマンスコンピューティング)ワークロードでは、ネットワーク帯域の確保が不可欠です。この場合、Elastic Fabric Adapter (EFA)を有効化することで、OSカーネルをバイパスした低遅延かつ高スループットなインスタンス間通信が可能になります。P4dやP5などのPシリーズで複数台を使った分散学習を行う場合は、EFAの利用を検討してください。
よくある質問(FAQ)
AWSのGPUインスタンスで一番安いのはどれですか?
「どれが一番安いか」は、リージョン、インスタンスサイズ、購入方法、OSによって変わるため、本記事では特定のインスタンスを断定していません。たとえば、AWSの公式仕様表には、G4dnやG5のほかに、Graviton搭載のG5g(NVIDIA T4g)、L4搭載のG6、GPUを分割して使えるG6fなども掲載されています。小規模な推論や開発用途では、これらも含めて、AWS公式のオンデマンド料金ページで比較してください。
さらにコストを抑えたい場合は、以下の購入オプションを組み合わせることが効果的です。
- 課金の単位:EC2の利用料金は1秒単位で課金されます(最小60秒)
- スポットインスタンス:オンデマンド料金から最大90%の割引が適用される(中断の可能性あり)
- Savings Plans:1年または3年の利用をコミットすることで、オンデマンド料金から最大72%割り引かれる
- EC2 Capacity Blocks for ML:機械学習のワークロード用に、GPUインスタンスを事前に予約できる
以下の表は、小規模な用途で候補になりやすいGPUインスタンスのスペックです。料金は変動するため、利用前にAWS公式の料金ページで確認してください。
| インスタンスタイプ | 搭載GPU | vCPU | メモリ (GiB) |
|---|---|---|---|
| g4dn.xlarge | NVIDIA T4 (1基) | 4 | 16 |
| g4dn.2xlarge | NVIDIA T4 (1基) | 8 | 32 |
| g5.xlarge | NVIDIA A10G (1基) | 4 | 16 |
AWSでGPUを使うためのクォータ引き上げはどうやりますか?
AWSの公式ドキュメントでは、「Running On-Demand G and VT instances」と「Running On-Demand P instances」のクォータ(vCPU数)の既定値は0とされています。スポットインスタンスにも、G・VT用とP用の別のクォータがあり、既定値は0です。そのため、利用を開始するには、AWSマネジメントコンソールの「Service Quotas」から上限緩和のリクエストを行う必要があります。
具体的な手順は以下の通りです。
- AWSマネジメントコンソールにログインし、「Service Quotas」を開く
- 左側のナビゲーションペインから「AWSのサービス」を選択し、「Amazon Elastic Compute Cloud (Amazon EC2)」をクリックする
- 検索窓で利用したいインスタンスファミリー(例:「Running On-Demand G and VT instances」「Running On-Demand P instances」)を検索する
- 該当する項目を選択し、「クォータの引き上げをリクエスト」ボタンを押す
- 必要なvCPU数を入力してリクエストを送信する
なお、公式ドキュメントによると、EC2はお客様の使用状況に応じて、オンデマンドインスタンスのクォータを自動的に引き上げることもあります。承認にかかる時間や、引き上げられる上限は状況によって異なるため、余裕を持って申請してください。
機械学習の学習と推論でGPUインスタンスを分けるべきですか?
機械学習プロジェクトにおいて、モデルの学習(トレーニング)と推論(デプロイ)では求められるリソース要件が大きく異なるため、インスタンスを分けて運用することが推奨されます。
学習フェーズでは、膨大なデータを並列処理してパラメータを更新するため、高い演算能力と広帯域なGPUメモリが必要です。この用途には、NVIDIA A100を搭載したP4dインスタンスや、H100を搭載したP5インスタンスなど、計算能力に特化したPシリーズが候補になります。
一方、推論フェーズでは、学習済みモデルにデータを入力して結果を出力するだけなので、学習時ほどの計算能力は不要です。推論にPシリーズを使用するとオーバースペックとなり、コストが跳ね上がります。推論用途には、NVIDIA T4を搭載したG4dnインスタンスや、AWSが独自開発した推論特化型チップを搭載するInf1/Inf2インスタンス(GPUではありませんが代替として強力)を選択することで、コストとパフォーマンスの最適化が図れます。
AWSのGPUインスタンスでWindowsは使えますか?
はい、AWSのGPUインスタンスでWindows Serverを利用することは可能です。EC2の起動時に、Windows ServerのAmazon Machine Image (AMI) を選択することで構築できます。
Windows環境でGPUを正しく認識し活用するためには、NVIDIAのグラフィックスドライバやGRIDドライバのインストールが必要です。AWSでは、これらのドライバがすでにインストール済みの「AWS Marketplace」で提供されている公式AMI(NVIDIAが提供するWindows向けAMIなど)を利用すると、初期設定の手間を省くことができます。
仮想ワークステーションとしての利用や、Windows環境に依存する3Dレンダリングソフト、動画編集ソフトをクラウド上で動かす用途として、G4dnやG5インスタンスとWindowsの組み合わせは広く活用されています。
AWSの無料枠でGPUインスタンスは使えますか?
EC2の無料利用枠(Free Tier)の対象インスタンスタイプとして、AWS公式ドキュメントに掲載されているのは、2025年7月15日より前に作成したアカウントでは「t2.micro」「t3.micro」、2025年7月15日以降に作成したアカウントでは「t3.micro」「t3.small」「t4g.micro」「t4g.small」「c7i-flex.large」「m7i-flex.large」です。この一覧にGPUインスタンスは含まれていません。
2025年7月以降に作成された新規アカウントには、最大200ドル相当のクレジットと6か月間の無料プランが用意されていますが、このクレジットをGPUインスタンスに使えるかどうかは、確認できていません。利用条件はAWS Free Tierのページで確認してください。
なお、無料のGPU環境として以前よく紹介されていたAmazon SageMaker Studio Labは、公式ドキュメントで「新規のお客様の受け付けを終了している」と案内されています。新たに利用を始めることはできません。
まとめ
この記事では、AWSのGPUインスタンスの種類と、ユースケース別の最適な選び方を解説しました。目的に合ったインスタンスを選択し、コストと性能を最適化することが重要です。
- 機械学習の学習処理には計算能力に特化したPシリーズ(P4d、P5、P6など)が候補になる
- 画像処理や推論、コスト重視の用途には汎用性の高いGシリーズ(G5、G4dn)が適している
- 環境構築時は最適なAMIの選択と、必要に応じたクォータ引き上げ申請を行う
AWSのGPU環境は、生成AI開発や画像処理など多様なニーズに対応します。まずは要件に合うインスタンスを選び、小規模なテストから実践してみましょう。